
製品・サービス・事例検索
業界・技術・コンテンツ種別から、自社製品・導入事例・ホワイトペーパーを横断検索。
AIオートメーション導入完全ガイド:PoCから本番運用までの7ステップと成功のポイント
AI導入は今や特別な取り組みではなく、多くの企業にとって前提条件となりつつあります。しかしその一方で、AIプロジェクトの失敗率は依然として高く、PoC(概念実証)で止まるケースが後を絶ちません。 実際、S&P Globalの調査では、企業の42%がAI施策の大半を中止しており、平均で46%のPoCが本番導入に至っていません。さらに、RAND CorporationはAIプロジェクトの80%以上が失敗していると指摘しています。 この背景にあるのは、技術そのものの問題ではありません。多くの場合、課題は「AIオートメーション導入の進め方」にあります。 AIは単なるツールではなく、業務プロセス・データ基盤・組織体制を横断する“実装のプロジェクト”です。戦略だけでも、モデル精度だけでも成功には至らず、エンドツーエンドで設計・運用されて初めてビジネス価値を生み出します。 本記事では、AIオートメーション 導入の全体像から、具体的な7つのステップ、実務で直面する課題、そして成功に導くためのポイントまでを解説します。 AIオートメーション導入とは何か AIオートメーション 導入とは、ビジネス課題の定義から始まり、安定したAIモデルを本番環境で運用し、継続的に改善していくまでの技術的ライフサイクル全体を指します。単なる「モデルのデプロイ」ではなく、データエンジニアリング、ソフトウェアアーキテクチャ、システム統合、そして組織変革(チェンジマネジメント)にまたがる複合的な取り組みです。 このプロセスは大きく3つのレイヤーで構成されます。まず戦略レイヤーでは、ユースケースの定義、ROIの測定、ビジネスケースの構築を行います。これは重要な出発点ですが、ここ自体が価値を生み出すわけではありません。次に実装レイヤーでは、データパイプラインの構築、モデル開発、既存システムへの統合が行われます。多くのプロジェクトがここで失敗します。最後に運用レイヤーでは、モニタリング、モデルドリフトの検知、再学習、インシデント対応などを行い、長期的な価値を維持します。 McKinseyの調査によると、AIから「大きな財務的リターン」を得ている企業は、モデリング手法を選定する前に、エンドツーエンドの業務プロセスを再設計している可能性が2倍高いとされています。つまり、プロセス改革が先、技術選定が後という順序が重要なのです。この違いこそが、PoC止まりのプロジェクトと、本番運用まで成功するAIオートメーション 導入を分けるポイントとなります。 3つのデリバリーモデルとその選び方 適切なデリバリーモデルの選定は、AIオートメーション 導入プロジェクトにおける最初の重要な構造的意思決定の一つであり、開発スピード、コスト、そして長期的な運用主体に直接的な影響を与えます。 インハウス(内製)モデルは、経験豊富な機械学習エンジニアやデータサイエンティストのチームをすでに有しており、外部共有が難しい機密性の高いデータを扱う場合、さらに長期的なチーム維持の予算が確保されている場合に適しています。 一方で現実的なリスクとしては、人材の確保が難しいこと、市場投入までの時間が長くなること、そして継続的な運用コストが積み上がることが挙げられます。 アウトソーシングモデルは、スピードが重視され、かつ社内にAIに関する専門知識が不足している場合に適しています。このアプローチの成功率は約67%とされており、内製開発と比べてほぼ2倍の成功率を示しています。 ハイブリッドモデルは、SotaTek Japanがエンタープライズ顧客に対して最も多く採用しているアプローチです。SotaTek Japanのエンジニアリングチームがコアシステムを構築する一方で、クライアントの社内チームが初期段階から参画し、知識を吸収しながら、リリース後の運用を担います。 このモデルにより、ベンダーロックインのリスクを低減し、開発期間を短縮すると同時に、社内の技術力強化も並行して実現できます。多くのエンタープライズ向けAIオートメーション 導入において、ハイブリッドモデルはスピード・コントロール・ナレッジ移転のバランスが最も優れた選択肢と言えるでしょう。 AIオートメーション 導入の7ステップと各段階における現実的リスク ステップ1:ビジネスニーズの評価と課題定義 このステップはしばしば軽視されがちですが、その後のすべての土台となる最も重要な工程です。SotaTekでは、すべてのAIプロジェクトにおいて、まずAIレディネス評価から開始し、組織の現状を以下の5つの観点で評価します:データ、テクノロジー、業務プロセス、ガバナンス、チームの能力。 この評価を基に、適切なAIユースケースを特定し、インパクトと実現可能性の観点から優先順位付けを行います。 開発に着手する前に明確にしておくべき重要な問いは次の通りです:どのKPIをどれだけ改善するのか?現在のベースラインは何か?ステークホルダーは誰で、どの程度コミットしているのか?成功とみなす基準は何か? これらが不明確なままでは、たとえ技術的に優れたAIオートメーション 導入であっても、ビジネス目標を達成することはできません。最もよくある失敗パターンは、「顧客体験の向上」といった曖昧な目標のままプロジェクトが開始され、成功かどうかの判断ができないまま終了するケースです。 ステップ2:オートメーション機会の特定と優先順位付け 実務において、最も効果的なAIオートメーション 導入は、高ROIかつ低複雑性の単一プロセスから着手することが多く、これにより短期間で成果(クイックウィン)を創出し、ステークホルダーの信頼を獲得することができます。 優れた初期ユースケースの条件は以下の通りです:高頻度であること、構造化データが存在すること、成果が測定可能であること、明確なビジネス価値があること、そしてリスク許容度が十分であること(安全性に直結する重要システムでないこと)。 評価には、ROIポテンシャル、技術的複雑性、データの準備状況という3つの軸を用いたマトリクスを活用します。この中でも「高ROI・低複雑性・データ準備済み」の領域にあるユースケースが理想的な出発点です。 最初のクイックウィンは単なる成果以上の意味を持ちます。それは、その後のプロジェクト推進に向けたモメンタムと社内合意形成を生み出す重要な要素となります。 ステップ3:データとインフラの準備 データ準備は、AIオートメーション 導入において最も過小評価されがちなフェーズであり、時間・コストの両面で想定を上回ることがほとんどです。成功しているAIプロジェクトでは、全体の約80%の期間と予算がデータ準備に充てられています。これには、データ抽出、正規化、ガバナンスメタデータの整備、品質管理ダッシュボードの構築、データ保持ポリシーの設計などが含まれます。 調査によると、80%の企業が自社データはAI活用に適していると考えていた一方で、実際には95%の企業がAI導入時にデータ関連の課題に直面しており、そのうち52%がデータ品質や構造に関する問題を抱えていました。 SotaTek Japanでは、こうした課題に対応するためにデータラベリングサービスを提供しています。これは多くの導入計画で見落とされがちですが、本番運用に耐えうる精度を実現するためには不可欠な要素です。特にLAON PEOPLEのようなパートナーからは、複雑で専門性の高い領域においても高精度かつ効率的なデータラベリングが可能である点が高く評価されています。 ステップ4:技術およびフレームワークの選定 技術スタックの選定は、流行ではなく解決すべき課題に基づいて行うべきです。例えば、コンピュータビジョンやドキュメント処理には、トランスフォーマーベースのモデルとOCRエンジンの組み合わせが有効です。NLPや対話型AIには、API経由の基盤モデルやファインチューニング済みモデルが適しています。製造業における予知保全では、センサーデータパイプラインと統合された時系列モデルが有力な選択肢となります。 SotaTek Japanは、LLMとRAG(Retrieval-Augmented Generation)を組み合わせ、企業内システムやデータと連携可能なAIエージェントの構築・学習・展開を実現するプラットフォーム「SotaAgents」を開発しました。これは、ナレッジマネジメントや顧客対応のオートメーションなど、大規模なインフラ投資を必要としないユースケースに最適です。 また、インフラは初期段階からスケーラビリティを考慮して設計する必要があります。適切な理由で選ばれた適切な技術スタックこそが、持続可能なAIオートメーション 導入と技術的負債の発生を分ける鍵となります。 ステップ5:モデルの開発とデプロイ このプロセスは直線的ではなく、反復的に進めるものです。一般的なサイクルは以下の通りです: […]

2026年のAIトレンド10選|ビジネスを変革する不可逆の変化
2026年、人工知能(AI)は、もはや単なる「効率化ツール」や「未来の技術」といった言葉で語られる存在ではなくなります。それは、ビジネスの戦略、社会の構造、そして私たち一人ひとりの日常に深く組み込まれた、電気やインターネットのような「基盤インフラ」へとその姿を変えようとしています。 これまでのAIが、特定のタスクを人間の代わりに行う「点の進化」だったとすれば、2026年に私たちが直面するのは、AIが自律的に思考・連携し、物理世界に介入し、さらには人間の創造性すら刺激する、複合的でダイナミックな「面の進化」です。 本記事では、AIトレンドの羅列に留まらず、それぞれの進化が私たちの世界に何をもたらすのか、具体的なビジネスシーンを交えながら、2026年のAI業界を形作る10の不可逆的な変化を徹底的に解説します 2026年の日本におけるAI市場規模 なぜ今、これほどまでにAIが注目されているのでしょうか。その背景には、日本市場におけるAIインフラ投資の、無視できない爆発的な成長があります。 事実、過去3年間でAIインフラへの支出は7倍に増加し、日本のIT基盤は大きな変化の渦中にあります。この急成長は当初、「経済安全保障推進法」に基づく政府主導のクラウド施策に牽引され、大規模なGPUサーバーの導入が加速しました。 しかし現在の成長は、もはや政策主導だけではありません。IDCの予測によると、日本のAIインフラ市場は2026年に前年比18%成長し、市場規模は55億ドルを超える見込みです。さらに2029年まで年平均13%で成長を続けると予測されており、この拡大が構造的かつ持続的なものであることを示しています。 特に注目すべきは2028年です。この年、日本においてAIインフラ支出が、非AIインフラ支出を史上初めて上回るという、歴史的な転換点が訪れると予測されています。AIはもはや実験段階ではなく、日本におけるインフラ投資の主要な推進力となりつつあるのです。 2026年のAIトレンド10選 トレンド1:AIエージェントとマルチエージェントシステム 概要 単一の万能AIにすべてを任せるのではなく、それぞれが異なる専門知識やスキルを持つ複数のAIエージェントが、あたかも人間の専門家チームのように自律的に連携し、複雑な目標を達成する仕組みです。プロジェクトマネージャーAI、リサーチャーAI、マーケターAI、ライターAIなどが協働し、一つの大きなタスクを遂行します。 重要性 人間のビジネスプロセスは、単一のスキルでは完結しません。市場調査、戦略立案、実行、分析といった複数の専門性が絡み合って初めて成果が生まれます。マルチエージェントシステムは、この複雑なワークフローそのものを模倣し、自動化することを可能にします。これにより、人間は「タスクの実行」から解放され、「最終的な意思決定」や「より高度な戦略策定」に集中できるようになります。 導入の課題 複数のAIエージェントを協調動作させるための高度な設計と制御が極めて複雑です。AIチームが意図しない動作をした際の原因特定や、最終的なアウトプットの品質保証が困難となる上、AIが自律的に下した判断によるビジネス上の損失発生時の責任の所在も大きな課題となります。 >>>関連記事:マルチエージェントシステムとは?仕組み、利点、課題、シングルエージェントとの違いなどを徹底解説! トレンド2:AIネイティブなソフトウェア開発 概要 「このような機能を持つアプリが欲しい」という自然言語での「意図(インテント)」をAIに伝えるだけで、AIがアプリケーションの要件定義、設計、コーディング、テスト、デプロイまでを自動的に行う開発手法です。プログラミング言語の知識がなくとも、誰もがアイデアを形にできる時代が到来します。 重要性 DX(デジタルトランスフォーメーション)の最大の障壁の一つであったIT人材不足と開発コストの問題を根本から解決する可能性を秘めています。ビジネスの現場にいる担当者が、自身の課題を解決するツールを自ら「創造」できるようになることで、企業のイノベーションは劇的に加速します。 導入の課題 AIが生成したコードの品質やセキュリティをどう保証するかが最大の課題です。また、ビジネス担当者の曖昧な「意図」をAIが誤って解釈し、期待と異なるシステムが構築されるリスクもあります。人間によるレビューと修正スキルは依然として不可欠です。 >>>関連記事:AIネイティブプラットフォームとは?特徴・メリット・課題・構築ステップを徹底解説! トレンド3:フィジカルAIとロボティクス 概要 AIの知能が、コンピュータの中だけでなく、ロボットアームや自動運転車、ドローンといった物理的な身体(フィジカル)と結びつき、現実世界で能動的にタスクを遂行する技術です。AIの「目」となる高度なセンサーと、「脳」となるリアルタイムの判断能力が、ロボットの可能性を飛躍させます。 重要性 これまでAIの影響が限定的だった製造、建設、農業、医療、物流といった「現場」の労働集約的な領域に、本格的な自動化の波をもたらします。特に、少子高齢化による労働力不足が深刻な日本において、社会インフラを維持するための不可欠なテクノロジーとなります。 導入の課題 AIソフトウェアに比べ、ロボット自体の初期導入コストが依然として高額です。また、現実世界の不確定要素(天候、予期せぬ障害物など)にAIが100%安全に対応することは技術的に難しく、特に人命に関わる領域での法整備や社会的な合意形成が追いついていません。 トレンド4:ハイパーパーソナライゼーションとマルチモーダルAI 概要 テキスト、音声、画像、表情、視線といった複数の情報(モダリティ)をAIが統合的に理解し、「その人が、その瞬間に、何を求めているか」を深く洞察。一人ひとりに最適化された情報や体験をリアルタイムで提供する技術です。 重要性 「マス(大衆)」に向けた画一的なサービスから、「個(パーソナル)」に徹底的に寄り添うサービスへの転換を決定づけます。顧客満足度を劇的に向上させるだけでなく、新たなニーズを掘り起こし、ビジネスチャンスを創出します。 導入の課題 高度なパーソナライズには、極めて詳細な個人データの収集が不可欠であり、プライバシー侵害との両立が最大の課題です。また、企業内の顧客データが部門ごとにバラバラに管理されている「データサイロ」の壁を越え、データを統合する基盤構築が前提となります。 トレンド5: AIの信頼性とセキュリティへの注力 概要 AIの判断プロセスが透明であるか(説明可能性)、特定のグループに不利益な判断を下していないか(公平性)、外部からの攻撃やデータ漏洩に対して堅牢であるか(堅牢性)といった、「信頼できるAI(Trustworthy AI)」を担保するための技術的・倫理的な取り組みです。 重要性 AIが金融、医療、採用といった人生を左右する重要な意思決定に関わるようになる中で、その判断が「ブラックボックス」のままでは社会に受け入れられません。AIに対する社会的な信頼を醸成し、安心してAIを活用できる環境を整備することは、AIの普及における大前提となります。 導入の課題 AIの判断根拠を完全に説明すること(説明可能性)は、特に複雑なディープラーニングモデルでは技術的に困難であり、性能とのトレードオフが生じます。また、AIの学習データに潜む無意識のバイアスを特定・是正することも難しく、継続的な監査体制とコストが必要となります。 トレンド6:ROIへのコミット — エンタープライズAIの導入とROI重視 概要 […]

RAG(検索拡張生成)とは?仕組み・メリット・VectorDBの役割を解説
近年、ChatGPTをはじめとする生成AIの普及により、企業におけるAI活用は急速に進んでいます。しかし一方で、「最新情報に対応できない」「自社データを活用できない」「誤った回答(ハルシネーション)」といった課題も明らかになってきました。 こうした課題を解決する技術として注目されているのが、RAG(検索拡張生成)です。RAGは、外部データを検索してから文章を生成することで、より正確で信頼性の高い回答を実現するアプローチです。 さらに、このRAGの性能を支える重要な基盤として「ベクトルデータベース(VectorDB)」が存在します。高速な類似検索を可能にすることで、大規模データを活用した高度なAIシステムを実現します。 本記事では、RAGの基本的な仕組みからアーキテクチャ、メリット・課題、具体的な活用事例までをわかりやすく解説するとともに、RAGに不可欠なVectorDBの役割についても詳しく紹介します。 RAG(検索拡張生成)とは? RAG(検索拡張生成)とは、検索モデル(Retrieval Model)と生成モデル(Generative Model)の強みを組み合わせた、高度な自然言語処理(NLP)技術の一つです。 検索モデルとは、ユーザーのクエリや文脈に応じて、大量のデータの中から関連性の高い情報を取得するシステムを指します。例えば、検索クエリに対して最も関連性の高いWebページを返す検索エンジンは、シンプルな検索モデルの一例です。一方、生成モデルは、言語生成能力を用いて新しい文章を生成できるモデルです。機械翻訳システムや対話型チャットボットなどが代表的な例として挙げられます。 従来のNLPシステムは、検索ベースのアプローチまたは生成ベースのアプローチのどちらか一方を採用するのが一般的でした。しかし、RAGはこれら2つの手法を組み合わせたアプローチです。RAGの基本的な考え方は、関連する背景知識にアクセスし、それを生成プロセスに活用することで、生成モデルの性能を大きく向上させることができるという点にあります。 例えば、RAGを利用した対話システムでは、まず会話の文脈に関連する文章やドキュメントを検索します。その後、取得した情報を生成モデル(seq2seqモデル)に入力し、回答を生成します。これにより、より知識に基づいた、文脈に合った自然な回答を生成することが可能になります。 このようにRAGは、関連情報を収集する高い検索能力と、自然で人間らしい文章を生成する能力を組み合わせたアプローチです。このハイブリッドな仕組みにより、オープンドメイン質問応答や対話システムなど、さまざまなタスクにおいて最先端の成果を実現しています。 RAGモデルの仕組み:アーキテクチャ概要 RAGモデルは、主に次の3つのコンポーネントで構成されています。 検索システム ナレッジソースやデータベースから、クエリに関連する文章やドキュメントを取得する役割を担います。検索方法には、疎ベクトル検索、密ベクトル検索、全文検索などがあります。 再ランキング 取得された複数の文章を再評価し、より関連性の高い順に並び替えます。通常は、クエリと文章の関係性をより精密に判断するためにクロスアテンションを用いたモデルが利用されます。 生成モデル 取得した文章を参照しながら、最終的な回答やテキストを生成する言語モデルです。一般的には、seq2seq(Sequence-to-Sequence)モデルが使用され、クロスアテンションによって検索結果の情報を取り込みながらテキストを生成します。 RAGの基本的な処理フロー RAGモデルが入力クエリを処理する一般的な流れは、次の通りです。 1. 入力クエリ 入力クエリは、検索クエリ、質問応答の質問文、対話システムの発話など、さまざまな形式のテキストが対象になります。 2. 検索 検索システムが、ナレッジソースからクエリに関連する上位k件の文章やドキュメントを取得します。この検索は、意味ベースの密ベクトル検索や、TF-IDFなどの疎ベクトル手法によって実行されます。 3. 再ランキング 必要に応じて、取得されたk件の文章を再評価し、より関連性の高い順に並び替えます。このプロセスにより、クエリに最も適した情報を選択できるようになります。 4. 生成モデルへの入力 再ランキングされた上位件の文章を、元のクエリと結合します。この結合された入力が、生成モデル(seq2seqモデル)に送られます。 5. 出力の生成 生成モデルは、テキストを生成する際に検索された文章を参照しながら処理を行います。その結果、質問への回答、対話の応答、要約などのテキストを生成します。 RAGモデルは、外部の知識を活用できる点が大きな特徴です。従来の生成モデルは、学習済みのパラメータだけに依存していましたが、RAGでは外部の知識ソースから情報を取得して生成プロセスに取り込むことができます。この仕組みにより、外部情報を利用できなかった従来の純粋な生成モデルと比べて、より正確で知識に基づいた回答を生成できるようになります。 RAGのメリット RAGは、生成AIモデルを特定のドメイン用途に適応させる際に、高額な再トレーニングコストを回避できるようにします。企業はRAGを活用することで、機械学習モデルの知識ベースの不足を補い、より質の高い回答を提供できるようになります。 コスト効率の高いAI導入とスケーリング AI導入時、多くの組織はまず基盤モデル(ファウンデーションモデル)を選択します。これは、より高度なモデル開発の基盤となる深層学習モデルであり、一般的にはインターネット上の公開データなど、トレーニング時点で利用可能だった情報をもとに構築されています。 しかし、基盤モデルの再トレーニングやファインチューニング(特定のドメインデータで再学習させること)は、計算コストやリソースの面で非常に負担が大きいです。RAGを活用すれば、企業は社内の信頼性の高いデータソースを利用しながら、再トレーニングなしで同様の性能向上を実現できます。また、コストやリソースの増加を抑えつつ、AIの導入規模を柔軟に拡張できます。 最新かつドメイン特化データへのアクセス 生成AIモデルには「知識カットオフ」と呼ばれる限界があり、トレーニングデータが最後に更新された時点以降の情報は反映されません。そのため、時間が経つほど情報の鮮度や関連性が低下します。RAGは外部データをリアルタイムで取得し、最新情報を回答に反映します。企業は顧客データ、研究資料、業界ドキュメントなど、特定の情報をモデルに提供できます。さらに、APIを通じてインターネットに接続することで、SNSの投稿やレビュー、ニュースなどを活用し、市場動向をより正確に把握できます。 AIのハルシネーション(幻覚)のリスク低減 GPTのような生成AIモデルは、データのパターンをもとに最も確からしい出力を予測しますが、実在しないパターンを誤って検出し、事実ではない情報を生成することがあります(ハルシネーション)。 RAGは、信頼性の高い外部データに基づいて回答を生成するため、こうしたリスクを低減できます。ただし、完全に誤りを防ぐものではありません。 ユーザー信頼の向上 チャットボットなどの生成AIが有効に機能するためには、ユーザーがその回答を信頼することが重要です。RAGは回答に情報ソースの引用を含めることができるため、ユーザーはその正確性を確認できます。また、企業内の複雑なデータ構造の中から、必要な情報へ直接アクセスできる点も大きな利点です。 ユースケースの拡張 より多くのデータにアクセスできることで、1つのモデルで対応可能なタスクの幅が広がります。RAGは複数のデータソースから情報を取得・統合できるため、複雑な問い合わせにも対応可能となり、企業はより高い価値を引き出せます。 開発者による制御性とモデル保守の向上 現代の企業は膨大なデータを扱っており、データパイプラインやストレージ設計がRAGの成功に不可欠です。開発者はモデルがアクセスするデータソースを柔軟に変更できるため、用途の切り替えも容易になります。新しいタスクに対応する際も、再トレーニングではなく外部データの調整で対応可能です。 […]

AIオートメーションの課題とは?企業導入で直面する8つの課題と解決策
AIオートメーションの課題は、企業がインテリジェントシステムを限定的なパイロット導入から本格的な運用へと拡張しようとする段階で、最も顕著に現れます。AIオートメーションは、業務効率の向上、コスト削減、意思決定の高度化を実現するデジタルトランスフォーメーションの中核技術として広く注目されていますが、実際に企業規模で導入を進めると、その裏側にある構造的な複雑さが明らかになることが少なくありません。 多くの業界では、人工知能を活用してドキュメント処理、詐欺検知、需要予測などの複雑な業務プロセスの自動化が進められており、自動化の範囲は従来のルールベースシステムを大きく超えて広がっています。しかし、これらのシステムが実際の業務環境に導入されると、企業はすぐにいくつかの限界に直面します。例えば、機械学習に適したデータが十分に整備されていないこと、レガシーインフラがシステム統合を制限していること、時間の経過とともにモデル性能が低下すること、そして期待されていたビジネス価値を定量的に測定することが難しいといった問題です。 フィンテック、ヘルスケア、サプライチェーン分野において企業向けソリューションを提供してきたAIおよびブロックチェーンのイノベーションパートナーであるSotaTekの経験から見ると、AIオートメーションの 課題には一定の共通パターンがあります。その根本原因はアルゴリズムそのものにあることは少なく、多くの場合、運用の複雑性、ガバナンスの不足、分断されたシステムアーキテクチャ、そして長期的に持続可能なAI運用モデルの欠如に起因しています。 こうした状況は、企業にとって重要な戦略的問いを生み出します。企業環境において最も重要なAIオートメーションの 課題は何でしょうか。なぜ多くの取り組みがPoC(概念実証)から本番運用へ移行する段階で停滞してしまうのでしょうか。そして、企業はどのようにすれば、統制され、スケーラブルで、長期的なビジネス目標と整合した形でAIオートメーションを導入できるのでしょうか。 本記事では、企業向けプロジェクトの実務経験に基づき、AIオートメーションにおける8つの主要課題を分析します。また、リスクを低減し、ガバナンスを強化し、AIオートメーションを短期的な実験から持続可能な企業能力へと転換するための実践的な戦略についても解説します。 データ品質と可用性の課題 データ品質は、AIオートメーションの最も重要な基盤です。企業環境において、AIシステムは信頼性の高い成果を生み出すために、大量かつ一貫性のある代表性の高いデータに依存しています。この基盤が弱い場合、オートメーションはすぐに不安定になり、スケールさせることが難しくなります。 実際の現場では、企業は以下のような課題に直面することが一般的です。 データ不足:多くの業界では、十分な量の過去データがまだ蓄積されていない。 データの不整合:データが複数のソースや形式から収集されるため、データパイプライン内にノイズが生じる。 学習データの不足:AIモデルは高い精度を実現するために数百万規模のデータポイントを必要とすることが多いものの、実際のデータセットは十分でない場合が少なくない。 これらの問題は、モデルの精度や信頼性に直接的な影響を及ぼします。SotaTek Japanの経験から言えることは、データ準備(データレディネス)に早期から取り組んだ企業ほど、AIオートメーションをPoC(概念実証)の段階から本格導入へと進められる可能性が高いということです。 標準化されたデータパイプラインの構築と、運用レベルでのデータガバナンスの確立は、持続可能なオートメーションを実現するための重要な条件となります。 影響領域 企業への影響 モデル精度 予測の信頼性が低下 オートメーションの信頼性 ユーザーの信頼が低下 スケーラビリティ 大規模展開時にAIが機能しない レガシーシステムとの統合の課題 AIオートメーションの導入が難しい主な理由の一つは、既存のレガシーシステムとの統合にあります。多くの企業の旧来のインフラは、インテリジェントオートメーションを前提として設計されておらず、最新のインターフェースや一貫したデータ構造を備えていないケースが少なくありません。 その結果、企業では以下のような問題が頻繁に発生します。 導入までの期間が想定より長期化する 統合コストが当初の見積もりを大きく上回る 実際の業務環境でオートメーションワークフローが安定して動作しない これらの課題に対して、より効果的なアプローチは段階的なモダナイゼーションです。ハイブリッドアーキテクチャ、ミドルウェア層、API、そして中央集約型データプラットフォームを活用することで、既存システムを全面的に置き換えることなく、AIシステムと既存技術を連携させることが可能になります。 課題 実際のビジネスへの影響 SotaTek Japanのアプローチ レガシーインフラ 最新の自動化システムと互換性がない クラウド移行とハイブリッドアーキテクチャの組み合わせ 分断されたシステム 部門間でデータサイロが発生 ミドルウェアとAPIゲートウェイによるデータ同期 高い統合コスト プロジェクト予算が2〜3倍に増加 MVPを優先した段階的統合ロードマップ モデル精度と信頼性の課題 従来の自動化とは異なり、AIオートメーションはデータから学習し、時間とともに適応するモデルに依存しています。そのため、AIオートメーションの主要な課題の一つが、データパターンが変化する中でもモデルのパフォーマンスを安定して維持することです。適切な監視体制が整っていない場合、モデルの精度は徐々に低下し、本番環境において信頼性の低い、あるいは誤解を招く結果を生み出す可能性があります。 実際の現場では、AIオートメーションの 課題は次のような形で現れることがよくあります。 実運用環境での結果のばらつき データ変化によるモデルドリフト AI意思決定の説明困難 SotaTekでは、これらの課題に対応するため、MLOpsフレームワークの中で継続的なモニタリングとExplainable AI(説明可能なAI)を導入しています。このアプローチにより、システムのライフサイクル全体を通じて、長期的な信頼性・透明性・ビジネス目標との整合性を維持することが可能になります。 […]
SotaTek Japan、「福岡オフィスオープニングセレモニーとベトナムナイト」を開催
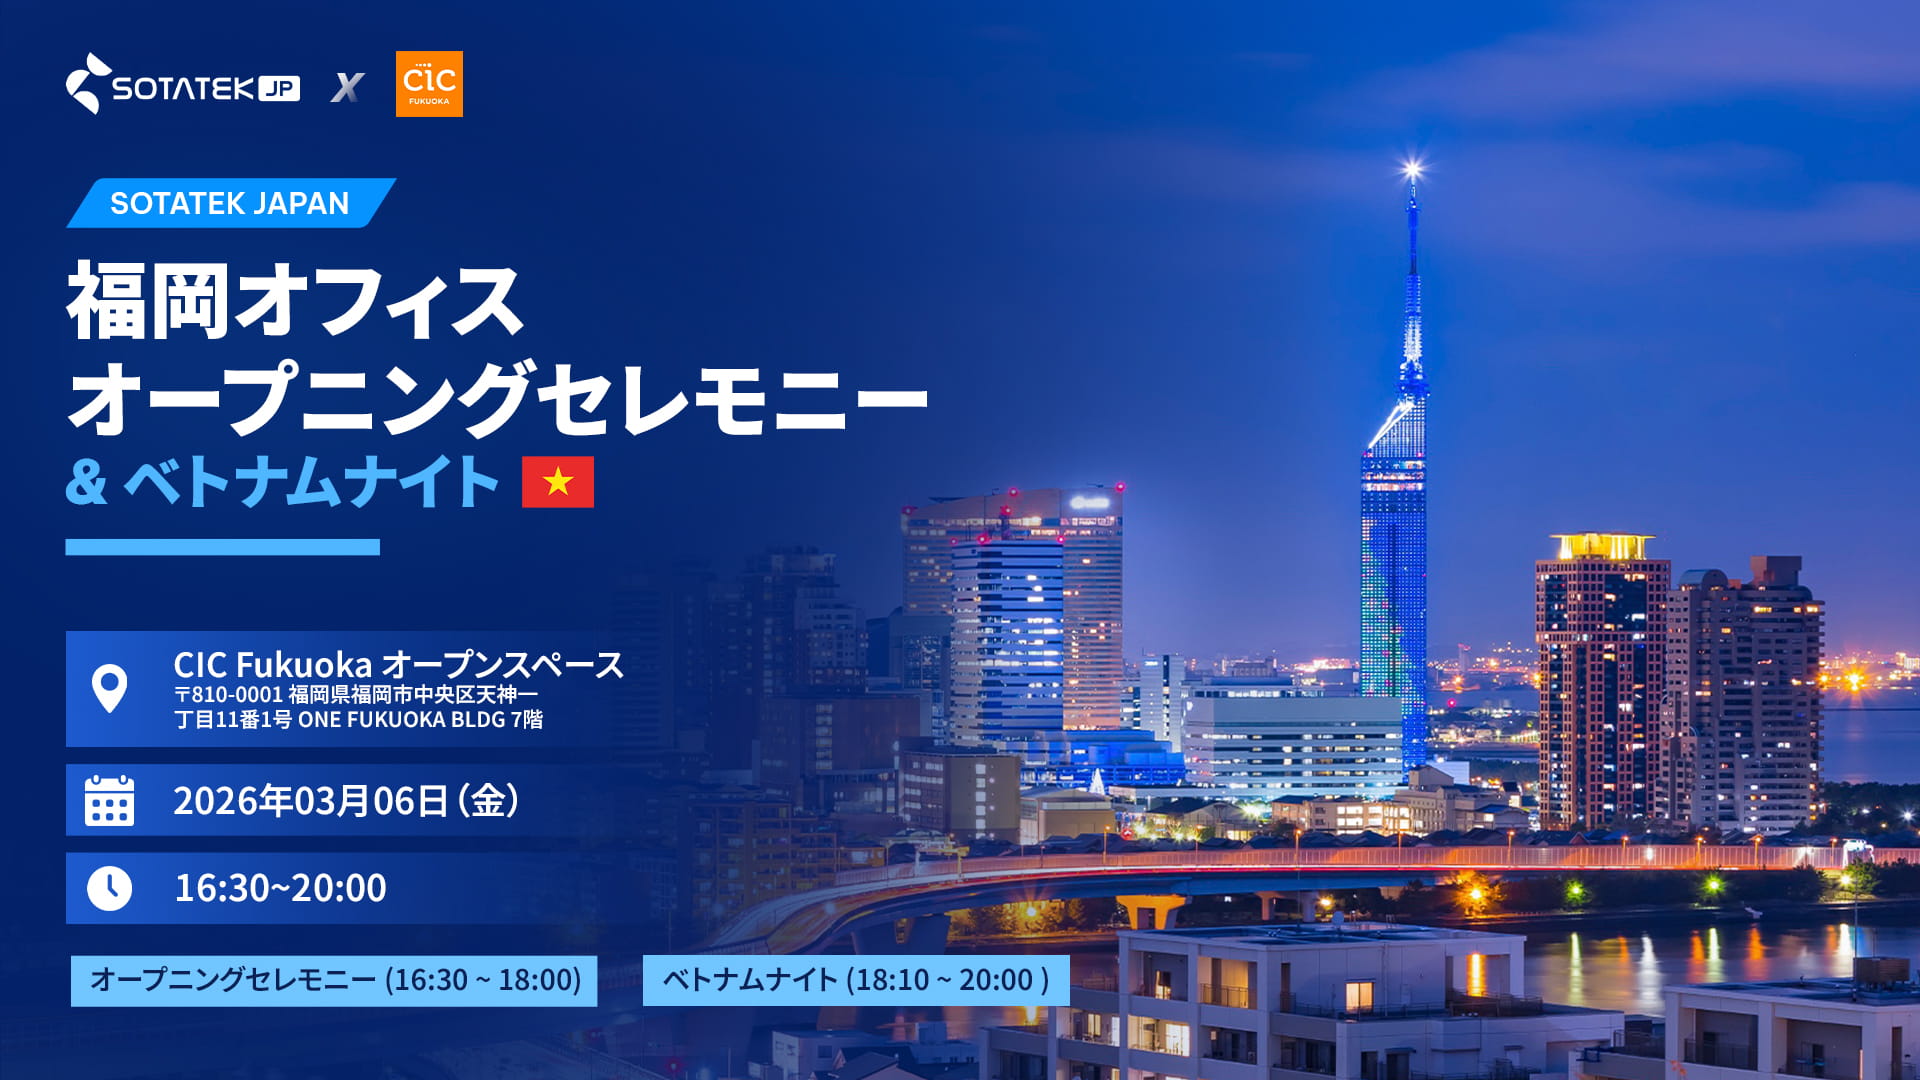
株式会社SotaTek Japan(以下、SotaTek Japan)は、福岡オフィスの開設を記念し、2026年3月6日(金)に「福岡オフィスオープニングセレモニーとベトナムナイト」を開催いたします。 本イベントは、福岡オフィスの正式開設を祝うオープニングセレモニーと、ベトナム文化・交流をテーマとしたネットワーキングイベント「ベトナムナイト」を組み合わせた交流イベントです。ベトナムナイトは、SotaTek JapanがCIC Fukuokaと連携して開催いたします。 日越ビジネス関係者、パートナー企業、行政関係者の皆様をお招きし、新たな連携やビジネス創出の機会を提供いたします。 開催概要 イベント名:福岡オフィスオープニングセレモニーとベトナムナイト 日時:2026年03月06日(金)16:30 ~ 20:00 会場:CIC Fukuokaオープンスペース 〒810-0001 福岡県福岡市中央区天神一丁目11番1号 ONE FUKUOKA BLDG 7階 主催:SotaTek Japan、CIC Fukuoka アジェンダ 受付 16:30 ~ 17:00 オープニングセレモニー 17:00 ~ 18:00 ベトナムナイト(CIC Fukuoka 合同開催) 18:10 ~ 20:00 SotaTek Japan 福岡進出の背景 福岡は、スタートアップ支援や国際ビジネスに積極的な都市として注目されており、アジアとの結節点としての高いポテンシャルを有しています。今回の福岡オフィス開設は、日本国内での事業基盤強化および日越間の技術・ビジネス連携をさらに加速させる重要な拠点となります。 特に、SotaTek Japanは「TEAM FUKUOKA(国際金融機能誘致推進協議会)」のメンバーとして、福岡が目指す国際金融都市の実現に貢献してまいります。自社の強みであるAIおよびブロックチェーン技術を最大限に活用し、金融業界のDX化(フィンテックの高度化)を強力に推進します。 さらに、福岡のスタートアップエコシステムを活かし、Web3・AI・DX分野の企業との協業やPoC支援を通じて、新たなビジネス創出を目指します。加えて、九州地域の企業に対し、業務効率化やAI導入を含む包括的なDX支援を提供します。福岡をニアショア開発拠点として活用し、オフショア開発と連携したハイブリッド体制により、高品質かつ効率的な開発サービスを提供してまいります。 SotaTek Japanについて SotaTekは、ベトナムのハノイで2015年に7名で創業し、2025年には1,500名以上の体制へと成長、現在も継続的に拡大を続けています。 株式会社SotaTek Japanは、SotaTekの日本法人として、日本のビジネス慣習に精通した体制のもと、国内クライアントとベトナムの開発拠点をつなぎます。AI・クラウド・業務システム開発を軸に、幅広い業界において、日本企業のDXに伴走するテクノロジーパートナーです。 SotaTek Japanは、ブロックチェーンとAIを融合した先端ソリューションを強みとし、政府系プロジェクトやグローバルフィンテック開発、AI移行支援などを展開しています。自社プロダクトには、大手企業向けAIエージェント「SotaAgents」、会議・ドキュメント業務を支援する「NoteX AI」、日本の医師200名以上が導入した「ChartX AI」、低遅延・高精度AI翻訳「TranleaX […]

企業向けAIセキュリティ完全ガイド:導入リスク・対策・活用事例まで徹底解説!
AIセキュリティとは、人工知能(AI)システムの完全性・機密性・信頼性を損なう脅威から保護するための分野です。AIのライフサイクル全体にわたって、データ、モデル、インフラを対象に、改ざん、不正利用、未許可アクセスを防止します。 効果的なAIセキュリティにより、AIシステムは意図された通りに動作し続け、長期的な信頼性を維持するとともに、安全かつ責任ある利用に関する新たな基準にも準拠することが可能になります。 本記事では、なぜ今AIセキュリティが重要視されているのか、AIシステムのどこにリスクが存在するのか、そして実務において求められる具体的な対策とは何かについて、わかりやすく解説していきます。 なぜAIセキュリティが注目されているのか? AIは、もはや「実験段階」から「本格的な社会実装」へと移行しました。 わずか数年の間に、AIモデルは研究室や実証実験の枠を超え、カスタマーサポート、金融判断、医療ツールなど、実際のビジネスや社会インフラを支える中核技術へと進化しました。 マッキンゼーの調査レポート「The state of AI: How organizations are rewiring to capture value(AIの現状:企業はいかに価値創出に向けて変革しているのか)」によると、回答企業の71%が、少なくとも1つの業務機能において生成AIを日常的に活用していると回答しています。これは、2024年初頭の65%、2023年の33%から大きく上昇しています。 つまり現在、AIシステムは機密データを扱い、ビジネスや社会に重大な影響を与える判断に関与する存在になっているのです。 この変化こそが、AIセキュリティが一気に中核的な課題へと浮上した理由です。 AI導入初期の目的は、「AIが本当に使えるかどうか」を検証することでした。しかし現在では、 学習データの汚染(データポイズニング) AIモデルの盗難 出力結果の悪用 といったリスクが、事業継続、企業ブランド、社会的信用に直結する深刻な問題となっています。かつては机上の空論だったリスクが、今や現場レベルの“運用上のリスク”へと変化したのです。 ガートナーは次のように予測しています。 2027年までに、AI関連のデータ侵害の40%以上は、国境を越えた生成AI(GenAI)の不適切な利用によって引き起こされる。 生成AIへの投資拡大は、あらゆる業界でAI活用を一気に加速させました。企業は、クラウドサービス、API、社内業務システムに次々とAIモデルを組み込み、スピード重視で導入を進めています。その結果、従来のソフトウェアとは比較にならないほど、攻撃対象となる領域(アタックサーフェス)が拡大しています。 さらにガートナーは、次のようにも予測しています。 「2026年に向けて、世界のAI関連支出は2兆ドル(約300兆円)を超える見通しであり、スマートフォンやPC、インフラ製品への組み込みが成長を牽引する」 AIの急速な普及と同時に、規制の整備も世界的に進んでいます。 EU AI Act(EU AI規則) 米国の連邦ガイダンス(NIST AIリスクマネジメント・フレームワークなど) ISO/IEC 42001(AIマネジメントシステム規格) これらは、AIのガバナンスとセキュリティに対して、明確な基準と責任を求める動きです。その結果、AIセキュリティは「やったほうがいい対策」から「守らなければならない経営要件」へと変化しています。 AIシステムにおけるセキュリティリスク AI セキュリティの重要性を理解した次に問うべきは、「具体的にどこを守るべきなのか」という点です。AI セキュリティは単一のレイヤーに限定されるものではなく、次のような複数の領域にまたがる包括的な分野です。 AIに入力されるデータ 出力を生成・処理するモデル ワークロードを保存・転送・実行するインフラ 安全かつ責任ある運用を保証するポリシーおよびガバナンス体制 これらの各領域には、それぞれ攻撃者に狙われやすい固有の脆弱性(失敗パターン)が存在します。つまり、AI セキュリティとは「技術そのもの」と「その使われ方の両方を守るための広範な取り組み」なのです。ここから、その実態を詳しく見ていきましょう。 データのセキュリティと完全性 データは、あらゆるAIシステムの基盤です。モデルの学習、振る舞い、判断のすべてはデータによって決定づけられます。そのため、収集・保存・利用のいずれかの段階でデータが侵害されれば、システム全体の信頼性と安全性が直接損なわれます。AI セキュリティでは、データのライフサイクル全体を通じて、「機密性・完全性・可用性(CIA)」を維持する厳格な管理体制が求められます。これには、データの取得方法、ラベリング、検証、不正アクセスや改ざんからの保護までが含まれます。 主なリスク データポイズニング:学習・微調整用データセットに悪意あるデータや誤誘導データを混入し、モデルの挙動を歪める攻撃 […]

AIセキュリティとは?重要性、機能、サイバーセキュリティとの違いなどを解決!
近年、生成AIや機械学習の急速な発展により、AIはもはや一部の先進企業だけの技術ではなく、あらゆる業界・業務プロセスの中核を担う存在となっています。業務効率化、高度なデータ分析、自動化、顧客体験の向上など、AIがもたらす恩恵は計り知れません。その一方で、AIの普及は新たなセキュリティリスクの拡大も意味しています。従来のサイバーセキュリティ対策だけでは防ぎきれない、AI特有の脆弱性や攻撃手法が次々と現れているのが現状です。 こうした背景から今、注目を集めているのが「AI セキュリティ」という考え方です。 本記事では、AI セキュリティの基礎概念から、サイバーセキュリティとの違い、重要性、メリット、主要な機能、そしてAIセキュリティの導入方法までをわかりやすく解説します。 AIセキュリティとは AI セキュリティとは、人工知能(AI)をサイバーセキュリティ分野に活用し、システムを悪意ある攻撃から守るための取り組みを指します。AI セキュリティは、大きく分けて2つの領域をカバーしています。 サイバーセキュリティにおけるAIの活用 AIを活用して脅威の検知・予防・対応を自動化することで、組織はサイバー脅威に迅速かつ正確に対応できるようになります。例えば、機械学習アルゴリズムは、ネットワーク上のトラフィックパターン、ログイン試行、ユーザー行動などの膨大なデータを分析し、リアルタイムで異常を検知します。通常の挙動から外れたものは即座にアラートとして検出され、迅速な対応が可能となるため、攻撃者よりも一歩先を行く防御が実現できます。 AIシステム保護 AIが金融、医療、政府機関などの分野に不可欠な存在となるにつれ、攻撃者はAIモデル自体を狙うようになっています。主な脅威には、AIの判断を誤らせる敵対的攻撃(Adversarial Attack)や、学習データを改ざんするデータポイズニング(Data Poisoning)などがあります。これらの脅威からAIを守ることで、AIの信頼性を確保し、安定した判断と消費者の信頼を維持することができます。このように、AIを活用したセキュリティ対策と、AIそのものを守るセキュリティ対策の両方を理解し、対策することで、組織はAIの強みを最大限に活かしつつ、高度化する脅威に対しても強固で信頼性の高いシステムを構築することが可能になります。 AIセキュリティとサイバーセキュリティの違い サイバーセキュリティは、デジタルシステム全体をサイバー脅威から守ることを目的とした、広範なセキュリティ分野です。一方、AI セキュリティは、前述した以下の2つの特定の領域に焦点を当てています。 AIを活用してセキュリティ脅威を検知・対応すること AI特有のプロセスそのものを保護すること 特に後者の「AI固有のプロセスの保護」に注目すると、追加の防御対策を講じなければ、AIモデルは悪意ある攻撃によって容易に侵害される可能性があります。 具体的には、以下のような脅威が存在します。 敵対的攻撃(Adversarial Attacks): 機械学習アルゴリズムを欺くように意図的に作られた入力データによって、誤った、または有害な出力を引き起こす攻撃。 プロンプトインジェクション(Prompt Injection): 操作されたプロンプトや指示を生成AIに入力することで、意図しない、または危険な出力を生成させる攻撃。 データポイズニング(Data Poisoning): 学習用データを意図的に改ざんし、AIモデルの学習内容を歪め、性能を低下させたり、不正確な予測を行わせたりする攻撃。 ネットワークセキュリティやクラウドのID管理といった従来のサイバーセキュリティ対策も依然として重要ですが、AI セキュリティはそれに加わる専門的な追加レイヤーといえます。AIのライフサイクル全体において、出力結果が改ざんされないようにするためには、学習(トレーニング)、導入(デプロイ)、運用・監視(モニタリング)の各段階を適切に保護する必要があります。AIの能力が進化するにつれて、攻撃対象となる領域(アタックサーフェス)や潜在的なセキュリティリスクも同時に拡大していきます。そのため、今後はAIシステムの安全性を確保し、機密情報を守るために、より高度なAI セキュリティの専門知識が不可欠になるといえるでしょう。 AIセキュリティの重要性 AIシステムは現在、AIアシスタントやチャットボットから、金融・医療分野における高度なデータ分析に至るまで、私たちの日常サービスの中核を担う存在となっています。その一方で、AIの普及は、データの窃取、サービス妨害、ブランドや企業の信用失墜を狙う悪意ある攻撃者にとって、格好の標的となることも意味します。このような脅威を回避するため、AI開発者はAIシステムを脅威から守り、消費者の信頼を維持するための対策を継続的に強化しています。 技術の進歩は、常に諸刃の剣です。AIシステムが進化する一方で、攻撃者もまた、脆弱なシステムを突く技術を巧妙化させています。特に、クラウド環境に依存するAIプロセスは、常に攻撃のリスクにさらされているのが現状です。 例えば、オーストラリアの大手銀行や、国家レベルの医療データベースで稼働しているAIアプリケーションが標的型攻撃を受けたとしたら、その影響は計り知れません。さらに、AIシステムとそれを支えるクラウドセキュリティの両方が侵害された場合、被害は一層深刻なものになります。 こうしたリスクに備えるためには、 AIを活用したセキュリティ対策(高速な脅威検知、より賢い防御) AIそのものを守るセキュリティ対策(敵対的攻撃の防止、データ保護) この両面に同等に注力することが不可欠です。これにより、サービスの安定運用、顧客情報の保護、そしてAIを活用したサービスに対する信頼の維持が実現できます。さらに、コンプライアンスの観点も重要です。各国政府が「AIの無法地帯」とも言える現状に対応するため、データガバナンスやAI規制を整備し始める中で、AI セキュリティは今後、義務として求められる重要な要素になっていきます。最終的な指針となるのは、適切なセキュリティ対策を通じて、AIを社会にとって“善の力”として機能させることにあります。 AI セキュリティのメリット AI セキュリティの最大のメリットは、自社の製品、そしてそれを利用する顧客を守れることにあります。このように考えてみてください。AIシステムを適切に保護することで、データの完全性とモデル出力の正確性を維持することができます。もし攻撃者がAIに入力されるデータを改ざんしてしまえば、AIの判断や予測結果は歪められ、信頼できないものになってしまいます。敵対的攻撃やデータポイズニングを防ぐことにより、AIモデルは常に信頼性の高い結果を出し続けることが可能になります。 また、強固なAI セキュリティは、脅威の検知と対応をより迅速に行えるというメリットももたらします。監視ツールによって、不審な挙動や新たな攻撃手法を早期に検出できるため、被害が拡大する前に予防的な対策を講じることが可能になります。 技術的なメリットだけでなく、「消費者からの信頼」という重要な価値も見逃せません。企業が責任あるAI運用とデータ保護に真摯に取り組んでいることが伝われば、ユーザーは安心して自分の情報を提供し、AIサービスを利用するようになります。AI技術・製品・サービスの多くは、顧客がデータを共有してくれることを前提に成り立っています。そのため、顧客の信頼と協力(カスタマーバイイン)は極めて重要です。ユーザーが安心して提供したデータを活用することで、パーソナライズの精度が向上し、製品の価値が高まり、さらに信頼が深まるという好循環(ポジティブなフィードバックループ)が生まれます。 特に、医療や金融といった規制の厳しい業界においては、データ保護は単なる努力義務ではなく、厳格なコンプライアンス要件として求められます。最終的に重要なのは、高度なAI機能と同時に、堅牢なセキュリティ体制を並行して成長させていくことです。この2つを両立させることで、リスクを最小限に抑えながら、安心してスケール(拡張)していくことが可能になります。顧客の期待を裏切ることなく、同時にデータガバナンス法にも準拠した運用が実現できます。 この意味において、十分なセキュリティ対策こそが、「安心してイノベーションに挑戦できる環境」を支える最大のメリットだと言えるでしょう。 […]

ブロックチェーン導入の現状まとめ:企業動向と2026年にブロックチェーントレンド
世界の企業ではいま、デジタル化の加速に伴い、「信頼できるデータ基盤」をどう構築するかが大きな課題となっています。AI、IoT、クラウドが急速に普及する一方で、データ改ざんリスク、コスト増大、コンプライアンス対応の複雑化など、従来のシステムでは解決しづらい問題が浮き彫りになっています。 こうした状況の中で注目を集めているのが ブロックチェーン です。単なる暗号資産の基盤技術ではなく、「信頼性・透明性・効率性」を同時に向上させる企業インフラとして再評価が進んでいます。金融、サプライチェーン、医療、保険、行政まで、多くの業界がすでに本格導入を始めており、ROI(投資対効果)の改善にも明確な成果が見られています。 本記事では、ブロックチェーントレンド、企業がブロックチェーンを導入することで得られる主要なメリット、実際の業界別ユースケースをわかりやすく解説します。 ブロックチェーン導入の現状 企業向けブロックチェーンは、もはや“選択肢の一つ”ではありません。急速な市場拡大、強い投資トレンド、そして高いコンプライアンスが求められる業界での実証効果により、デジタルトランスフォーメーション戦略の中核へと変化しています。 グローバルのエンタープライズ・ブロックチェーン市場は2023年に96億ドルで、2032年には2,878億ドルへ到達すると予測されており、年平均成長率(CAGR)は47.5%に上ります。(出典:GM Insights) 金融サービスが採用をリードし、2025年の市場収益の41%を占めています。アプリケーション別では決済領域が42%を占め、最も大きな比率となっています。 ヘルスケア分野のブロックチェーン市場は、2025年の55億ドルから2030年には433.7億ドルへ拡大し、CAGRは52.5%に達します。 すでに39%の医療機関が、臨床データ交換や不正防止を中心に、ブロックチェーンを本番またはパイロット環境で活用しています。 60%以上の銀行が分散型台帳技術をテスト中で、決済高速化、不正削減、コンプライアンス対応を目的としています。 アジア太平洋地域は最も急成長する市場で、FinTechおよび医療DXに対する政府支援が追い風となっています。 データ保護ニーズが企業需要の58%を占め、金融・ヘルスケアが主導しています。 AI統合、コスト効率化、越境イノベーションが、BaaS(Blockchain-as-a-Service)やコンソーシアム型ネットワークの需要をさらに加速させています。 主要業界における2026年のブロックチェーントレンド ブロックチェーンの導入速度は業界によって大きく異なります。特に医療、金融サービス、そしてAI関連領域は独自の課題と機会を背景に導入が加速しており、既存システムでは解決できない問題に対してエンタープライズ・ブロックチェーンを活用し始めています。 医療 患者中心のアイデンティティ 医療分野で最も重要なブロックチェーントレンドトレンドの一つは、医療データの主導権を患者に戻す動きです。企業・ブロックチェーンにより、患者自身が医療データを所有し、アクセス権を付与・取り消しできる自己主権型アイデンティティ(Self-Sovereign Identity)が実現します。すべてのアクセスや操作がチェーン上に記録されるため、患者と規制当局の双方が「誰が、いつ、どのように」データを利用したのかを完全に把握できます。 メリット: 患者主導のIDモデルを採用する医療機関は、透明性を示すことで 信頼を獲得し、患者ロイヤルティを向上 できます。 病院や保険会社は データ管理における法的リスクを軽減 し、研究機関との コンプライアンスに準拠したデータ共有パートナーシップ を獲得しやすくなります。 患者側が許可したデータ流通を活用し、新たな収益モデル を構築できます。 例:Mayo Clinic 患者が医療データのアクセス権を管理できる分散型ヘルスデータの取り組みをパイロット導入できます。近い将来、患者が必要なタイミングで専門医に記録を共有できる仕組みが本格運用される可能性があります。これにより紹介プロセスの摩擦が減り、HIPAAやGDPRといった厳格な法規制への準拠も強化されます。 セキュアなデータ交換 医療データは依然としてサイロ化しており、病院・検査機関・保険会社が互換性のないシステムを使用しているため、診断の遅れや重複検査が生じています。企業・ブロックチェーンは信頼の共有レイヤーとなり、HL7 FHIRなどの国際標準に基づいて、電子カルテ(EHR)や臨床データを安全かつリアルタイムで交換可能にします。 メリット: 重複検査の削減により 数百万ドル規模のコストを節約できます。 データ連携の高速化により 治療成果と患者満足度を向上、結果として収益増加できます。 早期にブロックチェーンコンソーシアムへ参画した企業は、政府・研究機関・民間医療機関との新規パートナーシップを獲得 できます。 例:Kaiser Permanente 統合医療システムへの投資を続けており、来年には全国規模のブロックチェーン医療データネットワークへ拡大する可能性があります。これにより重複検査の削減、紹介の迅速化、診療効率の大幅な向上が見込まれます。 ブロックチェーン とIoMT(医療IoT)の統合 IoMT(医療IoT)はウェアラブル、インプラント、リモートモニタリング機器などを指し、リアルタイムで膨大な患者データを生成します。しかし、その正確性や改ざん防止は大きな課題です。これからのエンタープライズ・ブロックチェーンは、IoMTデータの真正性を保証する基盤となります。端末はデータのハッシュをオンチェーンに記録し、すべての値が追跡可能・改ざん検知可能となります。 メリット 信頼性の高いデバイスデータにより、断続的治療から継続的ケアモデルへ移行します。 […]

AIネイティブプラットフォームが拓く新時代:業界別事例から見る実装のリアル
AIの進化は、もはや業務効率化の手段にとどまらず、企業の構造そのものを再定義する段階へと移行しています。とりわけ「AIネイティブプラットフォーム」の登場は、これまでのシステム設計思想を根底から変える転換点となっています。 AIネイティブとは、AIを後付けで組み込むのではなく、最初からAIを中核に据えて設計されたプラットフォームを指します。これにより、データの収集・分析・意思決定・自動化が一連のプロセスとして統合され、企業は俊敏かつ知的に行動できるようになります。 本記事では、AIネイティブプラットフォームの導入状況や業界別の活用事例、そしてその構築における課題と成熟モデルを包括的に解説します。 導入状況 AIネイティブ・データプラットフォームは、いまや企業インテリジェンスの新たな中枢となりつつあります。スピード、ガバナンス、そして大規模なAI活用を前提に設計されたこのプラットフォームは、イノベーションを阻み、AIの取り組みを「実証実験の段階」にとどめてしまう従来型スタックに代わる存在です。 これまで使ってきたエンタープライズスタックは、学習や推論のためではなく、データの保存とレポート作成を目的に構築されたものでした。 そのため、多くのPoC(概念実証)はデモではうまくいっても、本番環境では停滞してしまいます。 従来のプラットフォームは、AIファーストの実行を想定して設計されていなかったのです。 導入の現実化と急速な拡大 AI(生成AIを含む)の企業利用は2023年から2024〜2025年にかけて急増し、多くの組織がすでに複数の部門でAIを活用しています。もはや「研究段階」ではなく、事業運営に欠かせない要素となっています。 (出典:McKinsey & Company) 予算の個別ツールから統合プラットフォームへの移行 企業データ管理市場は2024年に約1,010億ドル規模に達し、2032年には2,400億ドルを超える見込みです。これは、企業がデータとAIを統合したプラットフォームへの投資を進めていることを示しています。 (出典:Fortune Business Insights) M&AによるAI×データ基盤の再編 DatabricksはIcebergの開発元であるTabularを買収し、オープンテーブルフォーマットの相互運用性に注力しています。一方、SnowflakeはAIの信頼性向上を目的にTruEraを買収し、データガバナンスとモデルの信頼性を一体化しました。これらの動きは単なる機能拡張ではなく、アーキテクチャ全体を再構築する取り組みです。 >>>関連記事:AIネイティブプラットフォームとは?特徴・メリット・課題・構築ステップを徹底解説! AIネイティブ プラットフォームによる業界変革 AIネイティブ・フレームワークは、生成AIを巧みに活用し、さまざまな産業で革新を起こしています。これにより、企業は戦略的な進化と新たな価値創出の波を迎えています。 これらの高度な技術を業務の中核に組み込むことで、企業はこれまでにない効率性と創造性を引き出し、個別化された医療ソリューションからダイナミックな小売体験まで、変革的なアプリケーションを実現しています。 AIネイティブ技術と生成AIの融合は、産業構造そのものを再定義しています。これにより、企業は市場の変化に柔軟に適応し、需要を予測し、効率的に対応する力を高めているのです。 銀行業界におけるAIネイティブ プラットフォーム 銀行業界における大規模言語モデル(LLM)と生成AIの導入は、よりパーソナライズされ、効率的で安全な金融サービスへの大きな転換点となっています。AIネイティブ戦略を取り入れることで、銀行は生成AIの力を活用し、特にLLMを通じて業務や顧客体験の在り方を根本から変革しています。 この統合は、銀行の運営モデルを進化させ、業務の中核にAIを組み込むことで、顧客対応からバックエンド処理に至るまで、より精度が高く効率的なサービス提供を可能にします。AIを基盤に据えることで、銀行は業務プロセスを最適化するだけでなく、金融サービスの正確性・柔軟性・個別最適化を大幅に向上させ、顧客一人ひとりのニーズや嗜好に合わせたソリューションを提供できるようになります。 銀行が生成AIを活用する主な領域は次のとおりです。 顧客対応の強化:LLMを搭載したAIチャットボットやバーチャルアシスタントが、これまでにないスピードとパーソナライズで顧客対応や取引処理を行います。 不正検知の高度化:高度な機械学習モデルが、取引パターンをリアルタイムに分析し、不正の兆候を迅速に検知・防止します。 ローン審査の最適化:AIシステムが膨大な顧客データをもとに信用リスクを即時に評価し、ローン承認プロセスを効率化します。 財務予測とリスク管理:生成AIモデルが市場動向や顧客行動を予測し、より正確な財務計画やリスクマネジメントを支援します。 このように、AIネイティブな銀行運営は、「迅速・安全・パーソナライズされた」金融サービスの実現を加速させています。AIが金融機関の中核に組み込まれることで、銀行はこれまでにないレベルの顧客体験と業務効率の両立を実現しつつあります。 医療業界におけるAIネイティブプラットフォーム AIネイティブ戦略は、生成AIを活用して診断精度を高め、患者ケアを個別化することで、医療業界に革命をもたらしています。これらの先進技術を統合することで、医療提供者はサービス提供のあり方を変革し、より高い効率性と精密さを実現しています。以下では、AIネイティブシステムが医療にどのようなインパクトを与えているかを紹介します。 AIによる診断精度の向上:生成AIモデルは医用画像データの解釈を大きく変革し、複雑な疾患の早期かつ正確な検出を可能にしています。この技術により、従来は達成困難だった精度での疾患診断が実現され、医療システムの診断能力が飛躍的に向上しています。 個別化された治療計画:生成AIの力を活用することで、医療提供者は個々の遺伝情報に基づいた治療計画を立案できるようになります。このパーソナライズドなアプローチにより、治療効果の最大化と副作用の最小化が両立され、患者一人ひとりの生物学的特性に最適化された医療が提供されます。 生成AIを医療業務に深く統合することにより、プロセスは効率化されるだけでなく、膨大な遺伝・医療データから継続的に学習することで進化し続けます。この継続的な適応能力によって、医療システムは患者ケア戦略を絶えず洗練させ、次のような成果を生み出します。 患者アウトカムの向上:AIネイティブシステムは、時間の経過とともに治療を最適化・適応させることができ、より効果的で個々の健康状態に応じた治療を提供します。その結果、患者全体の健康アウトカムが向上します。 業務効率の改善:AIネイティブな医療システムは、診断や治療計画にかかる時間とリソースを削減し、医療従事者が事務作業よりも患者ケアに集中できる環境を実現します。 通信業界におけるAIネイティブ プラットフォーム 通信分野にお*AIネイティブとは、AIを中核に据えて最初から設計されたプラットフォームを指します。これらのプラットフォームはAI機能に最適化されており、ユーザー体験データを活用するAIOps(AI for IT Operations)のような先進的なソリューションを提供します。具体的には、以下のような効果をもたらします。 問題の削減:AIが潜在的な障害を事前に検知し、問題が拡大する前に対処することで、ネットワークやサービスの中断を最小限に抑えます。 インテリジェントチケッティング:サポートチケットの作成から管理までを自動化し、人的負担を大幅に軽減します。 インシデント対応の自動化:AIが継続的な人間の介入を必要とせずにインシデントを処理することで、対応効率を高め、応答時間を短縮します。 ネットワークトラブルチケットの削減:AIネイティブシステムは、ユーザー体験に影響が出る前に問題を特定・解決することで、ネットワーク関連のトラブルチケット件数を大幅に減らすことができます。 また、AIネイティブな取り組みは、AIベースの独立したサービスの開発や、既存プラットフォームへのAI統合を含みます。たとえば、GoogleによるDeepMindの買収は、企業が自社の提供価値を高めるために、AIネイティブソリューションを「自社開発」または「買収」によって取り入れる好例といえます。 AIネイティブ実装の目的と環境 […]

AIネイティブプラットフォームとは?特徴・メリット・課題・構築ステップを徹底解説!
AIはもはや一部の業務を支援するツールではなく、ビジネスの中核そのものを再構築する存在へと進化しています。その象徴的なコンセプトが「AIネイティブプラットフォーム(AI Native Platform)」です。 近年、テクノロジー企業のみならず、金融、製造、流通など幅広い業界で「AIを中心に据えたシステム設計」への転換が始まっています。AIネイティブ化は単なる自動化ではなく、データと知能をプラットフォーム全体に組み込み、自律的に学び、最適化し続ける企業インフラを構築する取り組みです。 それでは、AIネイティブプラットフォームとは何でしょうか。 本記事では、AIネイティブプラットフォームの定義から特徴、実際の導入事例、得られる競争優位、そして構築に向けた実践ステップまでを包括的に解説します。 これからAIを本格的に活用していきたい企業にとって、戦略立案のヒントとなる内容です。 AIネイティブプラットフォームとは AIネイティブプラットフォームとは、人工知能(AI)がシステム全体に自然に組み込まれ、運用から実装、保守、最適化に至るまで中核的な役割を果たすプラットフォームのことです。 従来のように固定的なルールに従うのではなく、AIネイティブプラットフォームは常に学習・適応し、リアルタイムかつ文脈に応じた判断を行うことで、エンドツーエンドの意思決定を支えます。データを継続的に分析し、人の介入を最小限に抑えながら自律的に動作するのが特徴です。 イメージとしては、アプリを中心に設計された現代のスマートフォンと、後から無理やりアプリを追加した昔の折りたたみ式携帯電話の違いのようなものです。 AIネイティブ、組み込みAI、AI対応の比較 AIをどのようにシステムへ統合するかには、いくつかのアプローチがあります。ここでは代表的な3つの形態を比較しながら、それぞれの特徴と使いどころを整理してみましょう。目的や導入規模によって最適な方法は異なります。 アプローチ 意味 実例 適用すべきシーン AI対応(AI Enabled) 既存システムにAI機能を追加し、一部のタスクを自動化・効率化します。 既存のWebサイトにチャットボットを導入するケース 大きなシステム改修なしで、短期的な成果を得たいとき 組み込みAI(Embedded AI) プロダクト内の特定の機能やモジュールにAIを直接統合します。 ECアプリでの「おすすめ商品」機能など ユーザー体験を特定の領域で向上させたいとき AIネイティブ(AI Native) AIがプラットフォームの中核にあり、あらゆるプロセスや意思決定をAIが主導します。 テスラの自動運転システム(走行データを通じて全車両が学習) 高い適応性と知能を備え、持続的な競争優位を築きたいとき この違いは非常に重要です。なぜなら、どのアプローチを選ぶかによって、スケールの柔軟性、変化への適応スピード、そして最終的に提供できる価値が大きく変わるからです。 実際、ガートナー(Gartner)の予測によると、2026年までに、ビジネスユーザーの80%以上が「ダッシュボード」よりも、インテリジェントアシスタントや組み込み型アナリティクスによるデータ活用を好むようになるとされています。 >>>関連記事:【最新版】2026年のテクノロジートレンドトップ10 AIネイティブプラットフォームの特徴 AIネイティブプラットフォームには、他のシステムと一線を画す4つの基本特性があります。これらは単なる機能ではなく、設計思想そのものとして相互に連携し、プラットフォーム全体を支えています。 パーベイシブ・インテリジェンス 知能は特定の機能に限定されず、データ処理からユーザーインターフェースに至るまで、あらゆる層に存在しています。 たとえばNetflixのAIは、映画をおすすめするだけでなく: 視聴環境に応じたストリーミング品質の最適化 利用者ごとに異なるサムネイル画像のパーソナライズ サーバー負荷の予測・管理 など、複数の知的プロセスを同時に実行しています。 つまり、AIは単一機能の追加要素ではなく、プラットフォーム全体を駆動するエンジンとして機能しているのです。 継続的な学習と適応 AIネイティブシステムは、人手による更新を必要とせず、時間の経過とともに自ら賢く進化します。 これは以下のような学習サイクルに基づいています: データ収集:ユーザー行動・操作・結果の観察 パターン認識:何が有効で何が問題かの分析 自動調整:リアルタイムで戦略の修正 検証とフィードバック:結果を測定し、次の学習に活用 […]
【最新版】2026年のテクノロジートレンドトップ10
2026年、変革のスピードはこれまでにないほど加速しており、AIはもはや「選択肢」ではなく「前提条件」となっています。 「2026年 Gartner IT Symposium/Xpo」では、ガートナーのDistinguished VP Analyst ジーン・アルバレス氏とVP Analyst トリ・ポールマン氏が登壇し、今年の主要な戦略的テクノロジートレンドは単なる新興イノベーションではなく、CIOやITリーダーがレジリエントな基盤を構築し、インテリジェントなシステムを統合し、企業価値を守るための不可欠なツールであると強調しました。 本記事では、2026年のテクノロジートレンドトップ10、それぞれの概要、注目されている理由、できることを解説します。 2026年の注目すべき戦略的テクノロジートレンドトップ10 2026年は、破壊的変化・イノベーション・リスクがかつてないスピードで加速する、テクノロジーリーダーにとって極めて重要な年になります。 Gartnerが発表した「2026年の戦略的テクノロジートレンド・トップ10」は、単なる技術動向ではなく、ビジネス変革の触媒であり、Cレベル(経営層)の対応を求める内容です。 今年のトレンドは、「AIが駆動するハイパーコネクテッドな世界」における現実を反映しており、もはや単一の技術や能力だけでは対応できません。ガートナーは、今後リーディング企業がどのようにイノベーションを起こし、競争し、価値を守っていくかを示す3つのテーマに整理しています。 The Architect(アーキテクト) AIネイティブな開発プラットフォーム、AIスーパコンピューティング、コンフィデンシャル・コンピューティングなどを活用し、安全で、スケーラブルで、適応性の高いデジタル基盤を構築する。 The Synthesist(シンセシスト) マルチエージェントシステム、ドメイン特化型言語モデル、フィジカルAIといった多様な技術を統合し、新たな価値源を創出する。 The Vanguard(ヴァンガード) 予防的サイバーセキュリティ、デジタルプロベナンス、AIセキュリティプラットフォーム、ジオパトリエーション(データの地域主権管理)を通じて、信頼・ガバナンス・セキュリティを強化する。 この3つのテーマは、AI時代における組織の成功に欠かせない3本柱です。すなわち、「基盤を築く(Architect)」「価値を創出する(Synthesist)」「信頼を守る(Vanguard)」ことが、2026年以降の競争優位を左右します。 カテゴリ1:アーキテクト トレンド1:AIネイティブ開発プラットフォーム(AI-native development platforms) AIネイティブ開発プラットフォームとは AIネイティブ開発プラットフォームとは、生成AIを活用して、これまでになく迅速かつ容易にソフトウェアを開発できるプラットフォームのことです。 これらのプラットフォームには、単一のプロンプトからソフトウェアを生成する「ワンショット」型ツール、深い技術知識がなくても開発を可能にする「バイブコーディング」型ツール、そして複数のAIエージェントが連携してソフトウェアを構築する仕組みなど、さまざまな形態があります。 なぜ注目されているのか CIOs(最高情報責任者)はソフトウェア開発のスピード向上と生産性の改善に期待を寄せており、CEOやCFOはコスト削減の可能性に注目しています。 AIネイティブ開発プラットフォームを活用することで、「小規模チーム」が同じリソースでより多くのアプリケーションを構築できるようになります。たとえば、2人で構成された5つのチームが同時に5つのアプリケーションを開発できる、といった具合です。 このトレンドは、CIOが抱える開発バックログの解消を助けるとともに、「自社開発すべきか、外部から購入すべきか」という判断を“自社開発寄り”にシフトさせる要因となっています。 ガートナーの予測 ・80% の企業が、大規模なソフトウェアエンジニアリングチームを小規模なAI支援型チームへと進化させる見込みです。 ・40% の企業アプリケーションポートフォリオに、AIネイティブプラットフォームを活用して構築されたカスタムアプリケーションが含まれるようになります(これは2025年の 2% から大幅な増加です)。 アクションプラン ステップ アクション 期待される成果 ① プラットフォームチームの設立 AIネイティブ開発プラットフォームを管理し、使用するAIモデルを選定する専任チームを設立。 中央集約的な管理により、標準化とガバナンスの一貫性を確保。 ② セキュリティガードレールの実装 コードレビューやコンプライアンスチェックを行うAIガバナンスプラットフォームを統合。 セキュリティリスクやコンプライアンス違反のリスクを低減。 […]

OpenAI Codexとは?特徴、料金、Claude Codeとの比較などを解決!
近年、AIを活用したソフトウェア開発支援ツールが急速に進化しており、その中でも注目されているのがOpenAIが開発した「Codex」です。Codexとは 、自然言語をコードに変換する高度なAIモデルであり、日常的なプログラミング作業を効率化し、開発生産性を大幅に向上させることを目的としています。特に、コードのリファクタリング、テストの自動生成、ドキュメントの下書き、バグ修正など、繰り返しの多い定型作業に強みを持ち、すでにOpenAIの社内や外部企業でも活用が進んでいます。 一方で、Anthropic社が開発した「Claude Code」も同様に、高度なコード生成能力を持つAIとして注目を集めています。両者は類似したユースケースに対応できる一方で、設計思想や操作性、セキュリティ対応、チーム連携機能などに違いがあり、導入目的や開発スタイルによって適切な選択が求められます。 本記事では、Codexの基本機能や活用事例を紹介するとともに、Claude Codeとの違いについても詳細に比較し、どちらが自社の開発環境により適しているかを判断する一助となる情報をお届けします。 Codexとは? 出典:Open AI Codexとは、OpenAIが開発したAIエージェントベースのコード作成支援ツールです。従来の生成AIと異なり、Codexは「対話ベースで指示を受けながら、自律的にコードタスクを遂行するエージェント」として設計されています。 このCodexは、ChatGPTの上位プラン(Pro、Enterprise、Team)向けに提供が始まり、今後Plusや教育向けプラン(Edu)にも展開される予定です。 特徴 高度なAIエージェントによるコーディング支援 Codexは、OpenAIの最新モデル「codex-mini-latest」などを活用し、自然言語での指示に基づいてコード生成・修正・リファクタリングなどを行えるエージェントを実行します。これにより、エンジニアは仕様を自然言語で書くだけで、実装に必要なコードの下書きを自動で生成できます。 自然言語 → コードの変換 仕様やコメントからユニットテストを自動生成 コードのバグ検出と修正 古いコードのリファクタリングや命名変更 非同期的・継続的なエージェント実行 Codexは、一般的なチャットボットや生成AIとは異なり、「タスクを割り当てて待つ」という非同期型ワークフローに対応しています。ユーザーがタスクを定義すれば、Codexエージェントはそれを数分〜十数分かけて実行し、完了した結果を通知します。 人間の同僚のように「任せて、あとで確認」できる 複数のエージェントに並列でタスクを割り振ることも可能 バックグラウンドで重い作業を実行できる(例:巨大コードベースの解析) 開発ワークフローへの自然な統合 Codexは、エンジニアのワークフローに組み込む形で設計されており、GitHub、VSCode、CLIなどとの連携が進められています。また、OpenAIのChatGPT(Pro/Enterprise/Team)ユーザーは、ChatGPT内から直接Codexを呼び出して利用可能です。 ターミナル操作、Git操作、VSCodeとの連携 日々の開発フロー(バグ修正、コードレビュー、CI/CDタスクなど)に組み込める オートメーションエージェントとしての役割も期待 繰り返し作業の自動化と開発速度の加速 Codexは、次のような反復的・面倒な作業を自動化するのに特に強みがあります。 テストケースの作成・拡張 関数や変数名の統一 コメントの自動生成や更新 コードの整形・ドキュメント作成 これにより、エンジニアはより本質的な設計やアルゴリズムの検討に集中でき、開発速度が大きく向上します。 Codexの仕組み 出典:Open AI 現在、CodexにはChatGPTのサイドバーからアクセスでき、プロンプトを入力して「Code」をクリックすることで新しいコーディングタスクを割り当てることができます。コードベースに関する質問をしたい場合は「Ask」をクリックしてください。各タスクは、コードベースがあらかじめ読み込まれた、分離された独立の環境で個別に処理されます。Codexはファイルの読み取りや編集に加えて、テストハーネス、リンター、型チェッカーなどのコマンドも実行できます。タスクの完了には通常1〜30分程度かかり、その進捗はリアルタイムで確認できます。 Codexがタスクを完了すると、その変更はCodex専用の環境にコミットされます。Codexは、ターミナルログやテスト出力の引用を通じて、自身の処理過程を検証可能な形で提示します。これにより、タスクの実行中に行われた各ステップを追跡できます。結果を確認した後、さらなる修正を依頼したり、GitHubのプルリクエストを開いたり、ローカル環境に直接変更を統合したりすることが可能です。プロダクト内では、Codexの環境を実際の開発環境にできる限り近づけて構成することができます。 Codexは、リポジトリ内に配置された「AGENTS.md」ファイルによってガイドすることが可能です。これらはREADME.mdのようなテキストファイルで、Codexにコードベースの構造、テストの実行コマンド、プロジェクトの標準的な運用方法などを伝えるためのものです。人間の開発者と同様に、Codexエージェントも設定済みの開発環境、信頼性の高いテスト環境、明確なドキュメントが提供されているときに最良のパフォーマンスを発揮します。 なお、Codex-1はAGENTS.mdファイルやカスタムスキャフォールディングがなくても、コーディング評価や社内ベンチマークで高いパフォーマンスを示しています。 Codexの料金、課題 Codexは世界中のChatGPT Pro、Enterprise、Teamユーザーに順次提供を開始しています。PlusおよびEduユーザーへの提供も近日中に予定されています。今後数週間は追加費用なしで広く利用可能となっており、Codexの機能を自由に試すことができます。その後は、利用制限付きアクセスとオンデマンドで追加使用量を購入できる柔軟な料金プランが導入される予定です。 開発者向けには、codex-mini-latest モデルが Responses API 経由で提供されており、 […]