
近年、ChatGPTをはじめとする生成AIの普及により、企業におけるAI活用は急速に進んでいます。しかし一方で、「最新情報に対応できない」「自社データを活用できない」「誤った回答(ハルシネーション)」といった課題も明らかになってきました。
こうした課題を解決する技術として注目されているのが、RAG(検索拡張生成)です。RAGは、外部データを検索してから文章を生成することで、より正確で信頼性の高い回答を実現するアプローチです。
さらに、このRAGの性能を支える重要な基盤として「ベクトルデータベース(VectorDB)」が存在します。高速な類似検索を可能にすることで、大規模データを活用した高度なAIシステムを実現します。
本記事では、RAGの基本的な仕組みからアーキテクチャ、メリット・課題、具体的な活用事例までをわかりやすく解説するとともに、RAGに不可欠なVectorDBの役割についても詳しく紹介します。
RAG(検索拡張生成)とは?
RAG(検索拡張生成)とは、検索モデル(Retrieval Model)と生成モデル(Generative Model)の強みを組み合わせた、高度な自然言語処理(NLP)技術の一つです。
検索モデルとは、ユーザーのクエリや文脈に応じて、大量のデータの中から関連性の高い情報を取得するシステムを指します。例えば、検索クエリに対して最も関連性の高いWebページを返す検索エンジンは、シンプルな検索モデルの一例です。一方、生成モデルは、言語生成能力を用いて新しい文章を生成できるモデルです。機械翻訳システムや対話型チャットボットなどが代表的な例として挙げられます。
従来のNLPシステムは、検索ベースのアプローチまたは生成ベースのアプローチのどちらか一方を採用するのが一般的でした。しかし、RAGはこれら2つの手法を組み合わせたアプローチです。RAGの基本的な考え方は、関連する背景知識にアクセスし、それを生成プロセスに活用することで、生成モデルの性能を大きく向上させることができるという点にあります。
例えば、RAGを利用した対話システムでは、まず会話の文脈に関連する文章やドキュメントを検索します。その後、取得した情報を生成モデル(seq2seqモデル)に入力し、回答を生成します。これにより、より知識に基づいた、文脈に合った自然な回答を生成することが可能になります。
このようにRAGは、関連情報を収集する高い検索能力と、自然で人間らしい文章を生成する能力を組み合わせたアプローチです。このハイブリッドな仕組みにより、オープンドメイン質問応答や対話システムなど、さまざまなタスクにおいて最先端の成果を実現しています。
RAGモデルの仕組み:アーキテクチャ概要
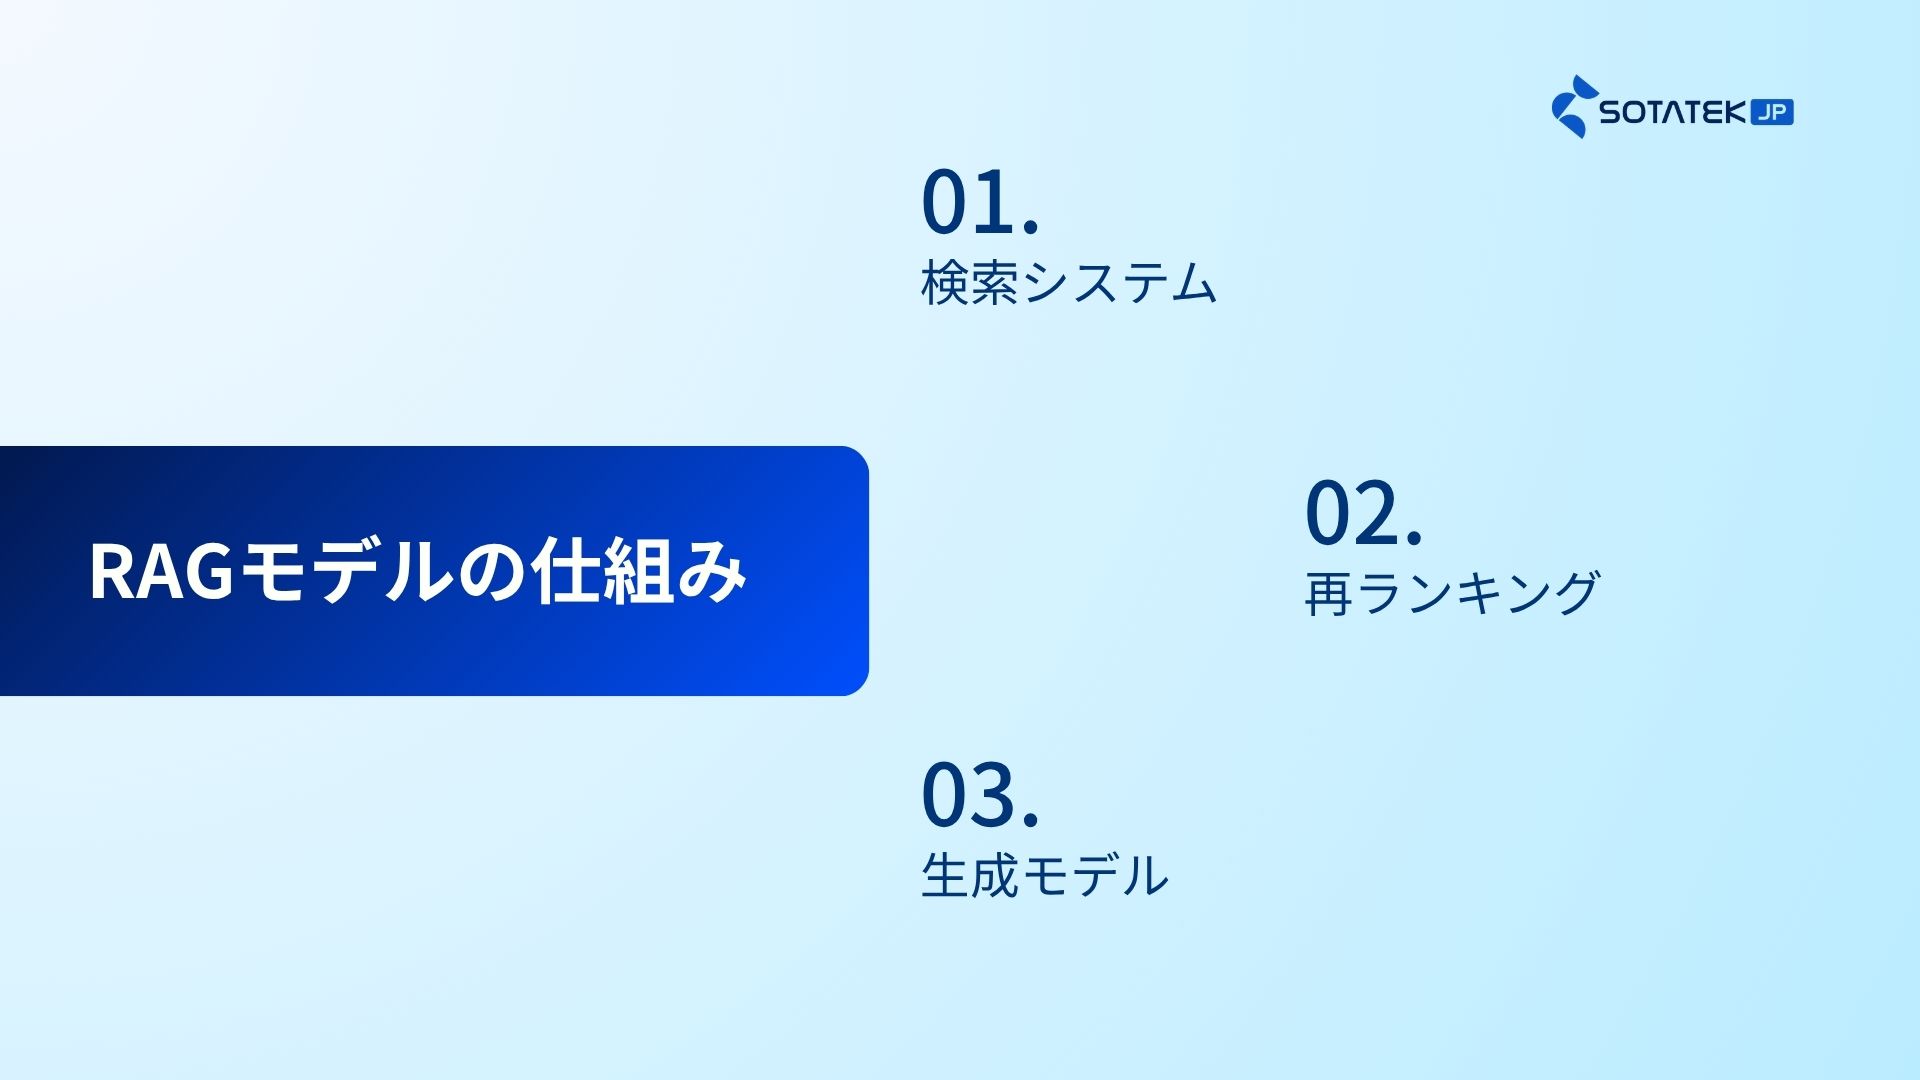
RAGモデルは、主に次の3つのコンポーネントで構成されています。
- 検索システム
ナレッジソースやデータベースから、クエリに関連する文章やドキュメントを取得する役割を担います。検索方法には、疎ベクトル検索、密ベクトル検索、全文検索などがあります。 - 再ランキング
取得された複数の文章を再評価し、より関連性の高い順に並び替えます。通常は、クエリと文章の関係性をより精密に判断するためにクロスアテンションを用いたモデルが利用されます。 - 生成モデル
取得した文章を参照しながら、最終的な回答やテキストを生成する言語モデルです。一般的には、seq2seq(Sequence-to-Sequence)モデルが使用され、クロスアテンションによって検索結果の情報を取り込みながらテキストを生成します。
RAGの基本的な処理フロー
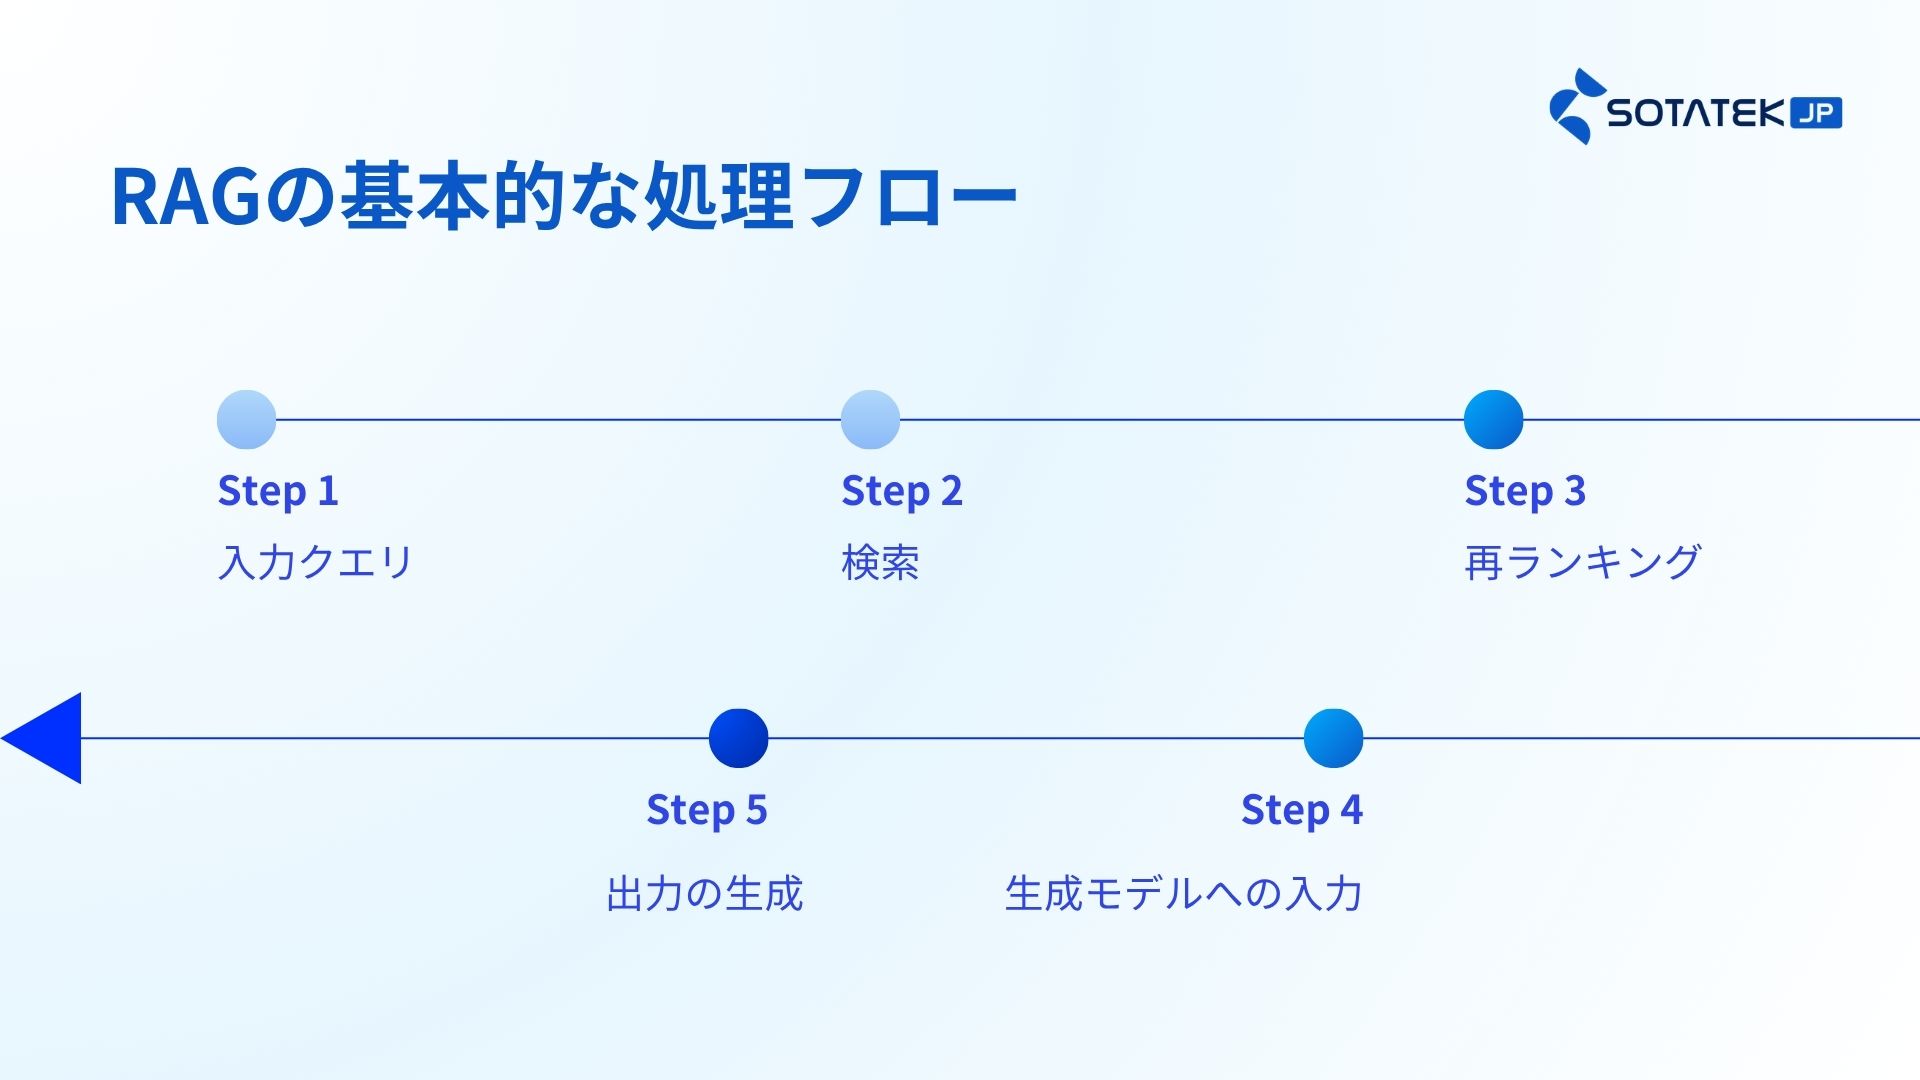
RAGモデルが入力クエリを処理する一般的な流れは、次の通りです。
1. 入力クエリ
入力クエリは、検索クエリ、質問応答の質問文、対話システムの発話など、さまざまな形式のテキストが対象になります。
2. 検索
検索システムが、ナレッジソースからクエリに関連する上位k件の文章やドキュメントを取得します。この検索は、意味ベースの密ベクトル検索や、TF-IDFなどの疎ベクトル手法によって実行されます。
3. 再ランキング
必要に応じて、取得されたk件の文章を再評価し、より関連性の高い順に並び替えます。このプロセスにより、クエリに最も適した情報を選択できるようになります。
4. 生成モデルへの入力
再ランキングされた上位件の文章を、元のクエリと結合します。この結合された入力が、生成モデル(seq2seqモデル)に送られます。
5. 出力の生成
生成モデルは、テキストを生成する際に検索された文章を参照しながら処理を行います。その結果、質問への回答、対話の応答、要約などのテキストを生成します。
RAGモデルは、外部の知識を活用できる点が大きな特徴です。従来の生成モデルは、学習済みのパラメータだけに依存していましたが、RAGでは外部の知識ソースから情報を取得して生成プロセスに取り込むことができます。この仕組みにより、外部情報を利用できなかった従来の純粋な生成モデルと比べて、より正確で知識に基づいた回答を生成できるようになります。
RAGのメリット
RAGは、生成AIモデルを特定のドメイン用途に適応させる際に、高額な再トレーニングコストを回避できるようにします。企業はRAGを活用することで、機械学習モデルの知識ベースの不足を補い、より質の高い回答を提供できるようになります。
コスト効率の高いAI導入とスケーリング
AI導入時、多くの組織はまず基盤モデル(ファウンデーションモデル)を選択します。これは、より高度なモデル開発の基盤となる深層学習モデルであり、一般的にはインターネット上の公開データなど、トレーニング時点で利用可能だった情報をもとに構築されています。
しかし、基盤モデルの再トレーニングやファインチューニング(特定のドメインデータで再学習させること)は、計算コストやリソースの面で非常に負担が大きいです。RAGを活用すれば、企業は社内の信頼性の高いデータソースを利用しながら、再トレーニングなしで同様の性能向上を実現できます。また、コストやリソースの増加を抑えつつ、AIの導入規模を柔軟に拡張できます。
最新かつドメイン特化データへのアクセス
生成AIモデルには「知識カットオフ」と呼ばれる限界があり、トレーニングデータが最後に更新された時点以降の情報は反映されません。そのため、時間が経つほど情報の鮮度や関連性が低下します。RAGは外部データをリアルタイムで取得し、最新情報を回答に反映します。企業は顧客データ、研究資料、業界ドキュメントなど、特定の情報をモデルに提供できます。さらに、APIを通じてインターネットに接続することで、SNSの投稿やレビュー、ニュースなどを活用し、市場動向をより正確に把握できます。
AIのハルシネーション(幻覚)のリスク低減
GPTのような生成AIモデルは、データのパターンをもとに最も確からしい出力を予測しますが、実在しないパターンを誤って検出し、事実ではない情報を生成することがあります(ハルシネーション)。
RAGは、信頼性の高い外部データに基づいて回答を生成するため、こうしたリスクを低減できます。ただし、完全に誤りを防ぐものではありません。
ユーザー信頼の向上
チャットボットなどの生成AIが有効に機能するためには、ユーザーがその回答を信頼することが重要です。RAGは回答に情報ソースの引用を含めることができるため、ユーザーはその正確性を確認できます。また、企業内の複雑なデータ構造の中から、必要な情報へ直接アクセスできる点も大きな利点です。
ユースケースの拡張
より多くのデータにアクセスできることで、1つのモデルで対応可能なタスクの幅が広がります。RAGは複数のデータソースから情報を取得・統合できるため、複雑な問い合わせにも対応可能となり、企業はより高い価値を引き出せます。
開発者による制御性とモデル保守の向上
現代の企業は膨大なデータを扱っており、データパイプラインやストレージ設計がRAGの成功に不可欠です。開発者はモデルがアクセスするデータソースを柔軟に変更できるため、用途の切り替えも容易になります。新しいタスクに対応する際も、再トレーニングではなく外部データの調整で対応可能です。
データセキュリティの強化
RAGは外部データをモデルに直接学習させるのではなく、参照する形で利用するため、モデルとデータの分離を維持できます。企業は自社データを保護しながら必要な範囲でモデルにアクセスさせることができ、アクセス権の管理や取り消しも容易です。
ただし、外部データベース自体のセキュリティ対策は重要です。RAGで使用されるベクトルデータベースが侵害された場合、埋め込みデータから元データが復元される可能性があるため、暗号化などの対策が必要です。
なぜRAGにおいて効率的なベクトルストレージが重要なのか
RAGモデルの能力を支える重要な要素の一つが、ベクトルデータベースです。これは、初期の検索プロセスで使用される埋め込みを保存し、高速な意味検索を実現する役割を担っています。
RAGモデルが、数十億規模のテキストデータを含む巨大なコーパスを扱うためには、ベクトル表現を効率的にインデックス化し、高速に検索できる仕組みが不可欠です。
そこで重要になるのが、以下のような高度に最適化されたベクトルデータベースです。
- Weaviate
- Chroma
- FAISS
- Vespa
- Pinecone
これらのシステムは、数十億規模の文章やドキュメントのベクトルを保存し、低レイテンシーで類似検索を行うことを可能にします。
ベクトルデータベースの主な強み
ベクトルデータベースは、特に次のような機能に優れています。
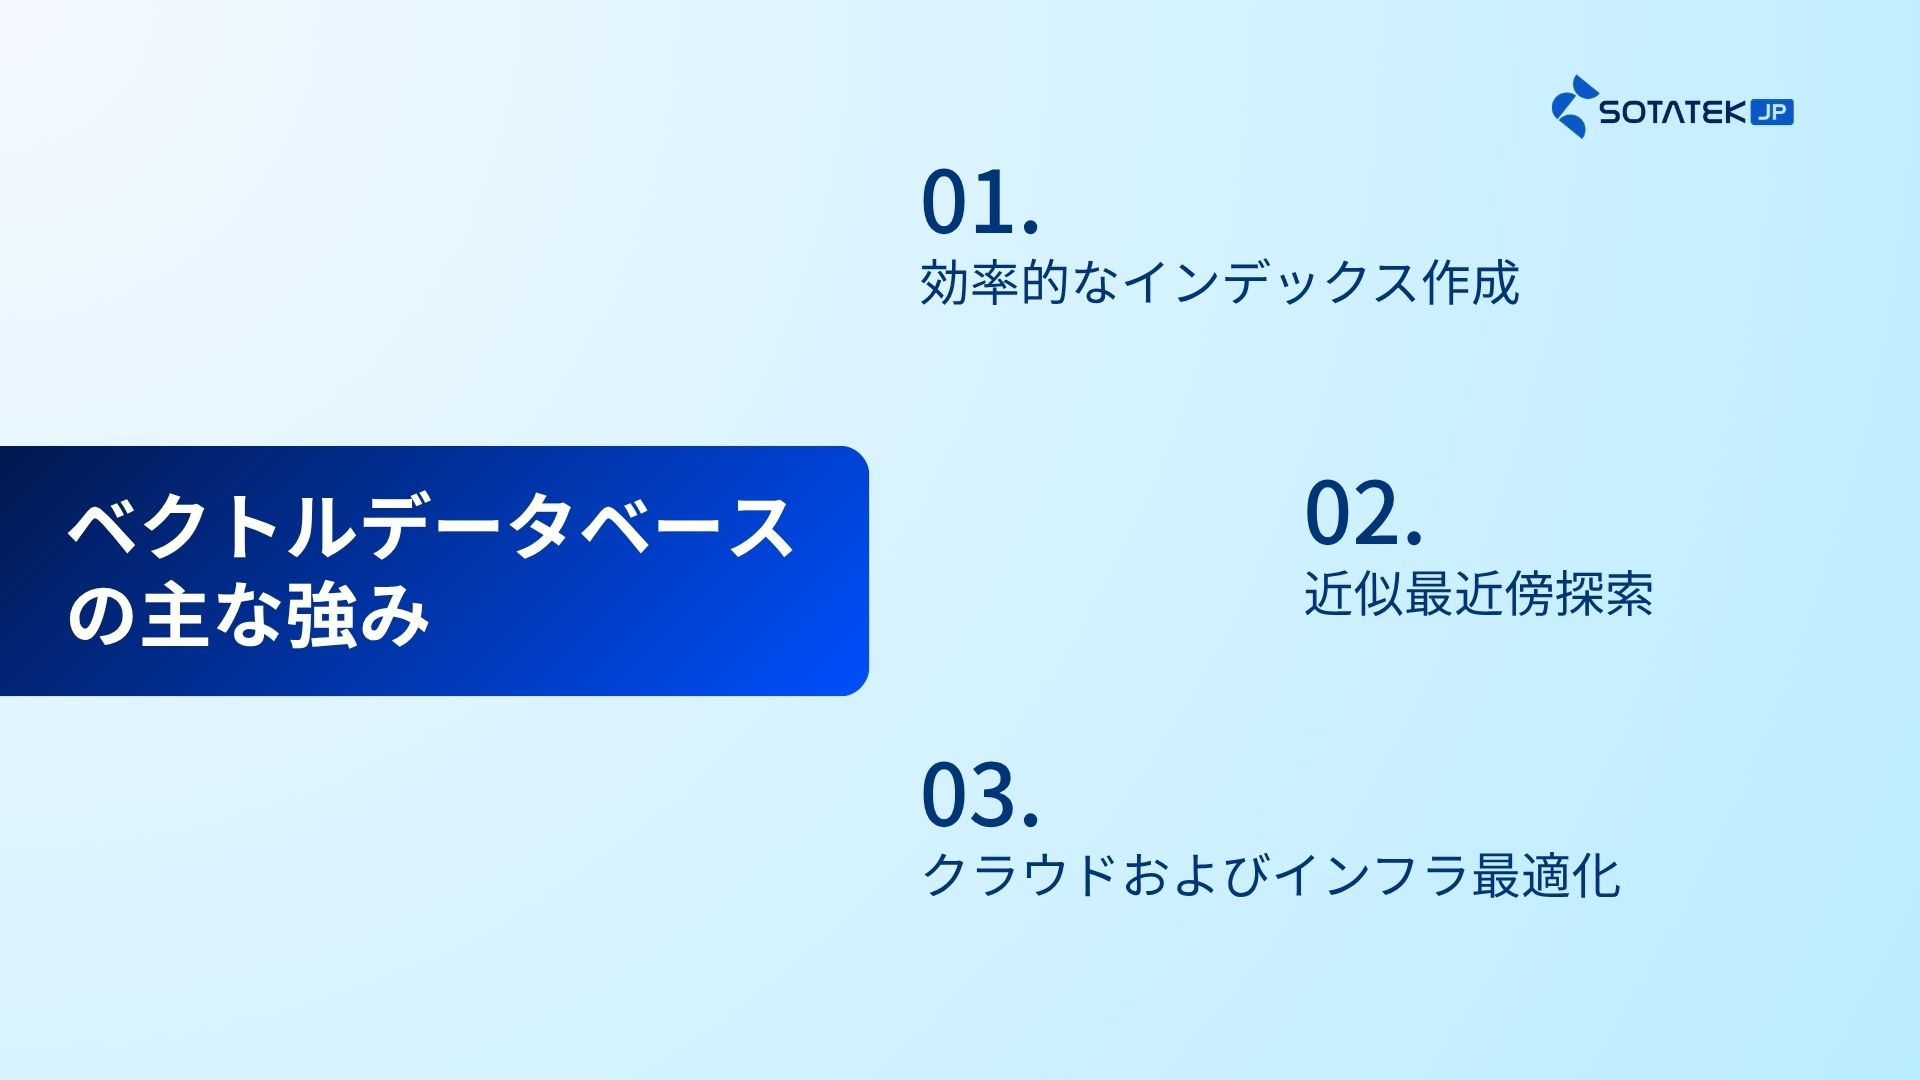
1. 効率的なインデックス作成
高度なデータ構造を利用してベクトル空間を圧縮し、検索性能を高めます。例えば以下の技術が使われます。
- 逆インデックス
- クラスタリングツリー
- 量子化アルゴリズム
これにより、GPUアクセラレーションによる高速処理も可能になります。
2. 近似最近傍探索
すべてのベクトルを完全に比較するのではなく、近似的に最も近いベクトルを高速に見つけるアルゴリズムを利用します。
代表的な手法には次のようなものがあります。
- ハッシュ検索
- HNSWグラフ
- Product Quantization
これにより、膨大なデータに対しても高速な検索処理が可能になります。
3. クラウドおよびインフラ最適化
多くのベクトルデータベースは、次のようなインフラ技術も活用しています。
- 分散コンピューティングクラスタ
- ロードバランシング
- ホットデータのキャッシュ
- 高度なクエリルーティング
こうした仕組みにより、世界中のサーバーを利用した大規模な検索処理を実現しています。もしこのような大規模ベクトルデータベースが存在しなければ、RAGモデルは検索処理が遅くコストも高くなるため、実用的に運用することは難しいでしょう。
高速なベクトル検索が可能になることで、RAGシステムでは検索レイテンシーではなく、むしろエンコーダやデコーダの処理がボトルネックになるほどの性能を実現できます。ベクトルデータベースは、RAGのようなニューラル検索アプリケーションを支えるために設計された高速なベクトルデータベースの一例です。
このデータベースは、ベクトルの保存と近似最近傍探索に特化しており、余分な機能を排除したシンプルな設計によって、非常に高い検索速度とスケーラビリティを実現しています。
ベクトルデータベースの主な機能
1. ベクトルストレージ
VectorDBの主な役割は、高密度ベクトルの効率的な保存です。一般的なデータベースとは異なり、ベクトルデータ(浮動小数点数)に最適化されたデータ構造を採用しています。
2. GPUアクセラレーション
GPUコアを利用した並列処理により、非常に高速な検索処理を実現します。また、Faissなどのライブラリを活用して、インデックス作成や検索処理を高速化しています。
3. 分散アーキテクチャ
複数のサーバーにデータを分散して保存することで、巨大なベクトル空間を効率的に管理できます。この仕組みにより、数兆規模のベクトルデータでも高速な検索が可能になります。
4. クラウドネイティブ
サーバー管理やネットワーク設定を意識する必要がない、完全管理型のクラウドサービスとして提供される場合もあります。クエリ量に応じて自動スケーリングも行われます。
5. REST API
vectorDB.search や vectorDB.insert のようなシンプルなAPIエンドポイントを通じて、どのアプリケーションからでもベクトル操作が可能です。専用のデータベースクライアントを組み込む必要はありません。
6. 最新アルゴリズム
HNSW、IVF、OPQなどの最先端の近似最近傍探索(ANN)アルゴリズムを継続的に取り入れ、精度と速度の最適化を図ります。
ベクトルデータベースのパフォーマンスベンチマーク
ベクトルデータベースは、最先端のRAGモデルを支えるために十分なスケーラビリティと高いパフォーマンスを提供します。以下は、標準的な本番環境におけるベンチマークの一例です。
1. インデックス作成速度
- 1時間あたり4億8,000万件以上のベクトルを登録可能
- 120億件以上のベクトルを1日未満でインデックス化
- 巨大コーパスの反復的な再学習(イテレーティブな更新)を実現
2. クエリレイテンシー
- 通常の検索は10〜25ミリ秒で実行
- 99パーセンタイルのレイテンシーは約50ミリ秒
- 最大でも100ミリ秒以内に収まる設計
3. クエリスループット
- 1台あたり毎秒62,000件の検索処理が可能
- クラスタサイズに応じて線形にスケール
- オートスケーリングによりスパイク負荷にも柔軟に対応
4. インデックス容量
- 1クラスタあたり最大5兆件のベクトルを保持可能
- マルチクラスタ構成では数百兆規模まで拡張可能
- 実質的にインデックスサイズに制限なし
5. クラスタ構成
- 1クラスタあたり最大60台のサーバーで構成可能
- マルチリージョン対応
- 水平方向に無制限のスケーラビリティを実現
RAGの活用事例
専用データベースによるスケーラブルかつ低レイテンシーなベクトル検索により、これまで実現が難しかった多くのRAGユースケースが可能になっています。
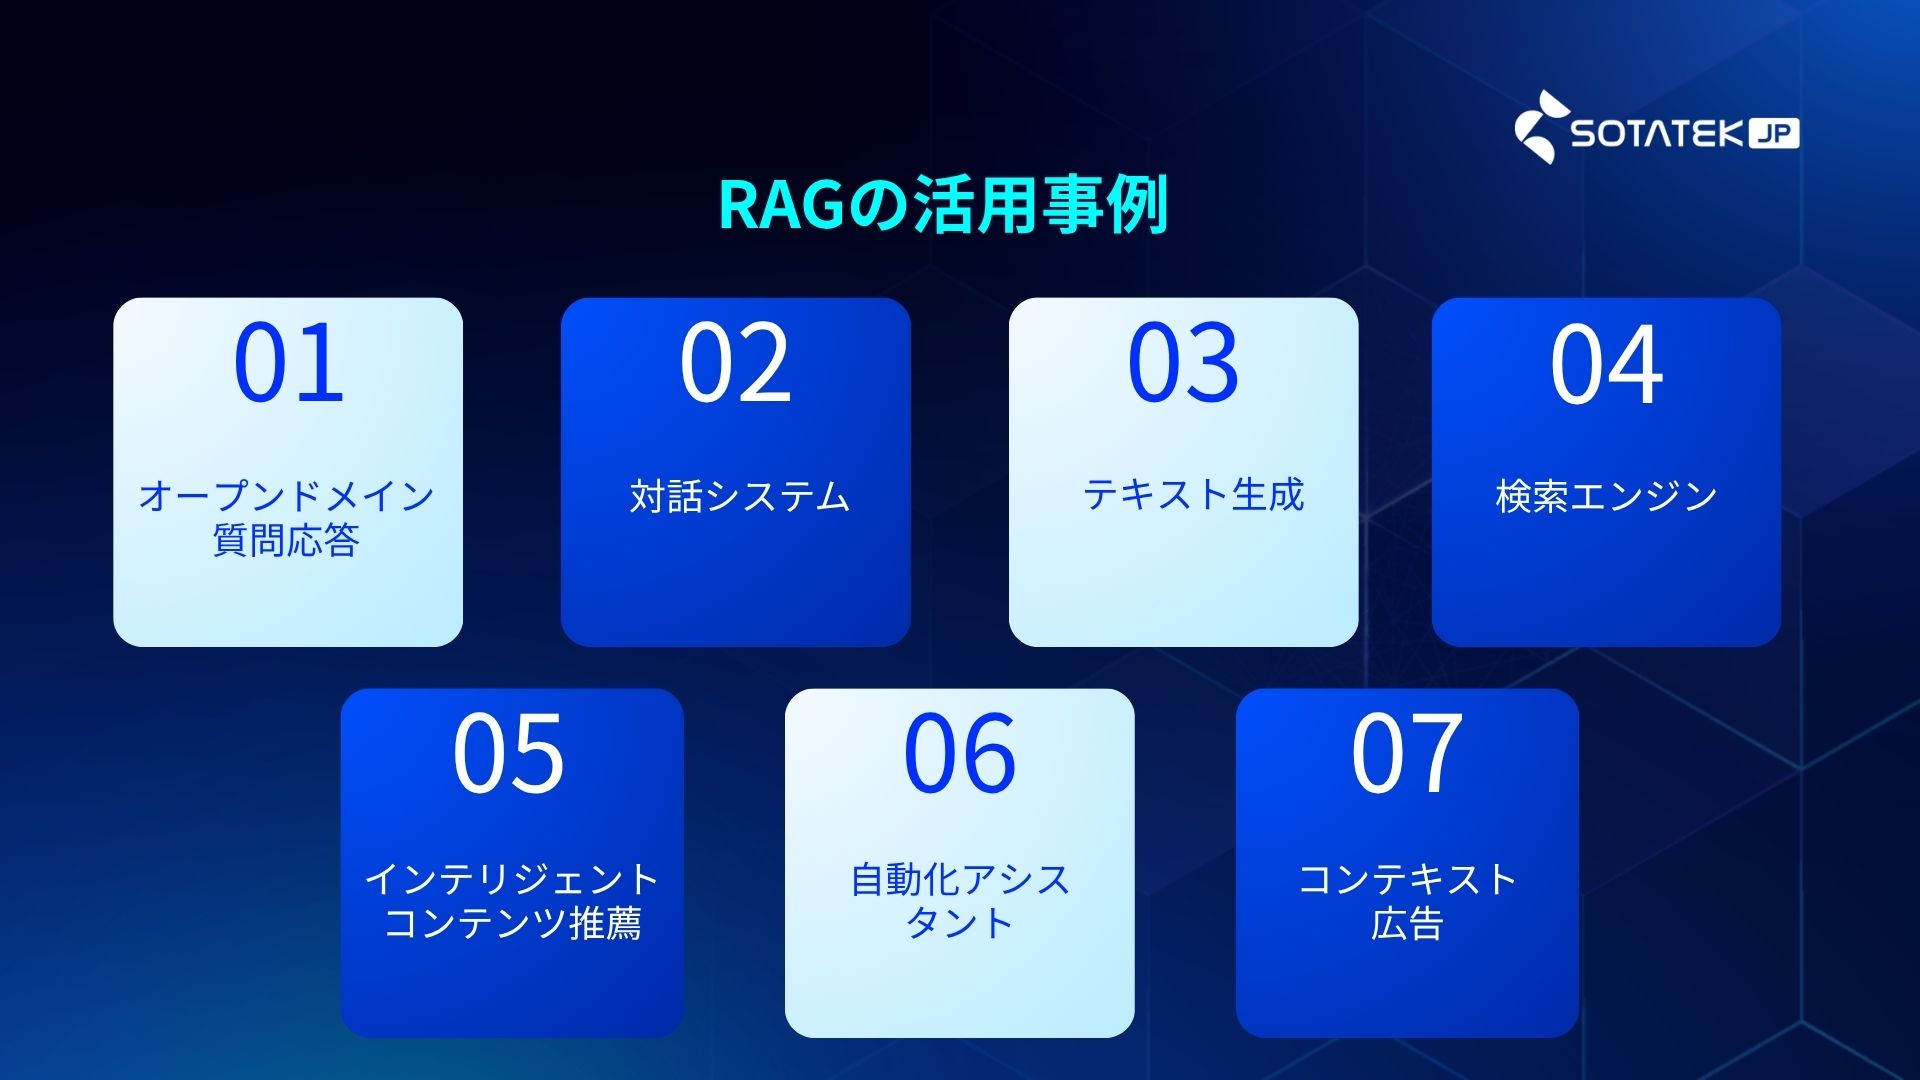
1. オープンドメイン質問応答
Wikipedia、ニュース、市場データ、論文などをインデックス化し、リアルタイムでの質問応答を実現します。
2. 対話システム
対話ログをインデックス化し、それを活用することで、文脈に沿った知識豊富な応答を提供するチャットボットを構築できます。
3. テキスト生成
小説やストーリーを取り込み、ユーザーのプロンプトに応じて詳細なコンテンツ生成を支援するクリエイティブツールに活用できます。
4. 検索エンジン
コーパスのメタデータに対するセマンティック検索により、より知的で要約された検索結果を提供します。
5. インテリジェントコンテンツ推薦
ユーザーの行動や嗜好に基づいて関連コンテンツを推薦し、その理由も説明可能です。
6. 自動化アシスタント
マニュアルや技術ドキュメントを検索し、複雑な製品のトラブルシューティングを支援するヘルプデスクボットに活用されます。
7. コンテキスト広告
ユーザーの閲覧履歴やセッション文脈に基づき、広告クリエイティブやランディングページを最適にマッチングします。これらは、ベクトル検索がRAGモデルにもたらす可能性の一部に過ぎず、コンシューマー向け・エンタープライズ向けの両方において多様な応用が期待されています。
RAGモデルの強み
RAGは、従来の純粋なニューラル言語生成モデルと比較して、以下のような優れた特長を持っています。
1. 高い事実精度
検索によって取得した根拠情報(エビデンス)に基づいてテキストを生成するため、事実に基づいた正確な回答が可能となり、ハルシネーションも大幅に減少します。
2. 大規模データへのスケーラビリティ
VectorDBのような専用ストレージにより、従来は困難だった数兆規模のデータを対象にした学習・推論が可能になります。
3. 高速性と効率性
最新のRAGアーキテクチャでは、インデックス作成・検索・生成処理が最適化されており、従来のモデルよりも高速に処理できます。
4. 幅広い適用領域
高精度かつスケーラブルであるため、オープンドメインQA、エンタープライズ検索、レコメンドなど、多様な分野で活用可能です。
RAGシステムの課題
最先端技術である一方で、RAGにはいくつかの課題も存在します。
1. 検索リコールの課題
初期の検索モジュールは、巨大でラベル付けされていないコーパス内に存在する関連情報を十分に拾いきれない場合があります。
2. 推論能力の不足
多くのRAGはデータ駆動型であり、論理的・記号的な推論能力が限定的です。そのため、複雑な構造を持つ質問への対応が難しい場合があります。
3. 曖昧性への対応の難しさ
検索プロセスは単一の正解や文脈を前提とすることが多く、曖昧・主観的・ニュアンスを含む質問への対応は依然として課題です。
4. 大規模な学習データの必要性
自己教師あり学習によってラベルなしデータを活用できるとはいえ、多くのRAGモデルでは依然として大量の教師データが必要であり、ニッチな分野ではデータ不足が問題となります。
よくある質問(FAQ)
RAGとは何の略ですか?
RAGは「Retrieval-Augmented Generation(検索拡張生成)」の略です。検索(Retrieval)と生成(Generation)を組み合わせることで、外部データを活用しながら高精度なテキスト生成を実現する技術です。
RAGとファインチューニングの違いは何ですか?
ファインチューニングは、モデル自体を追加データで再学習させる手法です。一方、RAGはモデルを再学習せず、外部データを検索して回答生成に活用します。
そのため、RAGは以下の点で優れています:
- 低コストで導入可能
- 最新データをリアルタイムで反映できる
- モデルの再学習が不要
ベクトルデータベースとは何ですか?
ベクトルデータベース)は、テキストや画像などをベクトル(数値表現)として保存し、類似度に基づく検索(セマンティック検索)を高速に行うためのデータベースです。RAGでは、検索フェーズにおいて最も重要な役割を担います。
なぜRAGにVectorDBが必要なのですか?
RAGでは、ユーザーの質問に対して関連情報を高速に検索する必要があります。VectorDBを使うことで、意味ベースの検索(類似検索)を低レイテンシーで実行できます。特に、大規模データ(数億〜数兆件)を扱う場合、従来の検索システムでは対応が難しく、VectorDBが不可欠になります。
RAGはどのような業界で活用されていますか?
RAGは幅広い業界で活用されています:
- カスタマーサポート(FAQボット、ヘルプデスク)
- 金融(レポート分析、ナレッジ検索)
- 医療(論文検索、診断支援)
- EC(商品推薦、検索)
- メディア(記事生成、要約)
RAGはハルシネーションを完全に防げますか?
いいえ、完全には防げません。
RAGは信頼性の高い外部データを参照することでハルシネーションのリスクを大幅に低減しますが、検索結果の質やモデルの生成プロセスによっては誤りが発生する可能性があります。
RAG導入の際の課題は何ですか?
主な課題は以下の通りです:
- 検索精度(リコール・ランキング)の最適化
- データの品質管理
- レイテンシーとコストのバランス
- セキュリティ設計
これらを適切に設計することで、RAGの効果を最大化できます。
RAGと従来の検索エンジンの違いは何ですか?
従来の検索エンジンは関連ドキュメントを提示するだけですが、RAGはその情報をもとに自然な文章として回答を生成します。
つまり:
- 検索エンジン:情報を「見つける」
- RAG:情報を「理解して答える」
という違いがあります。
まとめ
RAG(検索拡張生成)は、検索と生成を組み合わせることで、従来の生成AIが抱えていた「情報の古さ」や「ハルシネーション」といった課題を改善し、より正確で信頼性の高い回答を実現する技術です。さらに、VectorDBによる高速なベクトル検索が、その性能とスケーラビリティを支えています。
今後、企業におけるAI活用が進む中で、RAGはカスタマーサポート、ナレッジ検索、レコメンドなど幅広い領域で重要な役割を担っていくと考えられます。一方で、検索精度やデータ設計などの課題もあるため、適切な設計と運用が成功の鍵となります。
RAGとVectorDBを正しく理解し活用することで、より高度で実用的なAIシステムの構築が可能になるでしょう。
SotaTek Japanは、AI・クラウド・データ活用を強みとし、RAGや生成AIの導入から設計・開発・運用までを一貫して支援するITソリューション企業であり、VectorDBを活用した高度な検索システム構築などを通じて、日本企業のDX推進に貢献しています。