
OpenAIは、これまでに一般公開された中で最も高度なAIモデルとなる GPT-5.2 を正式にリリースしました。
GPT-5.2とは、企業の専門業務を想定して設計された高性能AIモデルです。推論能力、マルチモーダル知能、コーディング性能、長文コンテキスト処理、ワークフロー自動化といった主要分野で大幅な進化を遂げており、GPT-5.2は GPT-5.1以降で最大の飛躍 と広く評価されています。
本記事では、GPT-5.2の新機能、ベンチマーク、Gemini 3 Proとの比較について解説します。
GPT-5.2とは
GPT-5.2は、単なるチャットボットツールではなく、専門的な業務タスク向けに設計された最先端モデルとして位置づけられています。内部テストデータによると、本モデルは企業ユーザーにおいて、繰り返し作業に費やす時間を1日あたり平均40〜60分削減する効果が確認されています。 このバージョンの優位性は、高い正確性が求められる分野におけるマルチタスク処理能力において、特に顕著に表れています。 複雑なスプレッドシートの作成および分析 専門性の高いプレゼンテーション資料の構築 高い完成度を求められるプログラミング(コーディング) 画像の認識および長文ドキュメントの文脈理解 進化した推論能力と信頼性 大規模言語モデル(LLM)における最大の課題の一つは信頼性です。
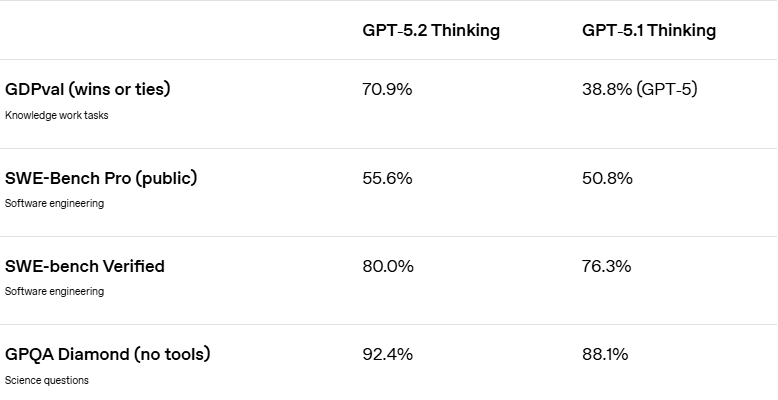
GPT-5.2では、この点において新たな性能基準が確立されています。 具体的には、GDPvalベンチマークで70.9%という非常に高いスコアを記録しました。これは、旧バージョンの38.8%からの大幅な飛躍を意味します。この結果は、AIが現在、44の職種において人間の専門家と同等、あるいはそれ以上のレベルで業務を遂行できることを示しています。
GPT-5.2の新機能
GPT-5.2は、推論(Reasoning)・メモリ(Memory)・ツール活用(Tool Use)の各分野において、より具体的かつ的確な改善が施されています。OpenAIの説明によれば、これらの強化により、エンタープライズ向けワークフローの品質向上と作業中の失敗ポイント削減が実現されます。GPT-5.2シリーズに含まれる3つのモデルは、それぞれ異なるアプローチでこの価値を提供します。
GPT-5.2 Instant
GPT-5.2 Instantは、低レイテンシーと高速レスポンスを最優先に設計されています。情報収集、文章作成、翻訳など、日常的な業務における汎用ワークホースとして位置づけられています。
多くのユーザーがデフォルトで利用するモデルであり、その強みは深い思考力よりも処理量(スループット)にあります。実務的には、高度な推論モデルを使うほどではないが、素早い回答や軽量な自動化が必要な場面に最適で、コストを抑えながら即時性を重視した用途に向いています。
GPT-5.2 Thinking
GPT-5.2 Thinkingは、拡張された推論能力を備えており、回答を出す前に複雑な問題を段階的に考え抜くことができます。
OpenAIのベンチマークでは、ナレッジワーク、コーディング、長文コンテキスト処理の分野で最高水準の結果を示しており、特にスプレッドシートやプレゼンテーションなどのツールを活用できる場合に高い性能を発揮します。
これは、OpenAIが目指す汎用的なナレッジワークエンジンであり、慎重な思考によって精度が向上するタスクに適したモデルです。多くの組織にとって、分析業務、マルチステップのワークフロー、エージェント型タスクの主力選択肢となるでしょう。
GPT-5.2 Pro
GPT-5.2 Proはシリーズのフラッグシップモデルで、エンタープライズ顧客向けに設計されています。
最も高価なモデルですが、それは推論品質、事実精度、抽象的な問題解決能力におけるわずかな向上が、コストに見合う価値を持つ高リスク環境を想定しているためです。
Proは、エラーが許されない場面や、非常に長いコンテキストにわたって一貫性を保つ必要がある環境での利用を想定しています。意思決定支援システム、複雑な計画立案、信頼性が能力と同等に重視される業務に適したモデルと言えるでしょう。
GPT-5.2のベンチマーク
コーディング
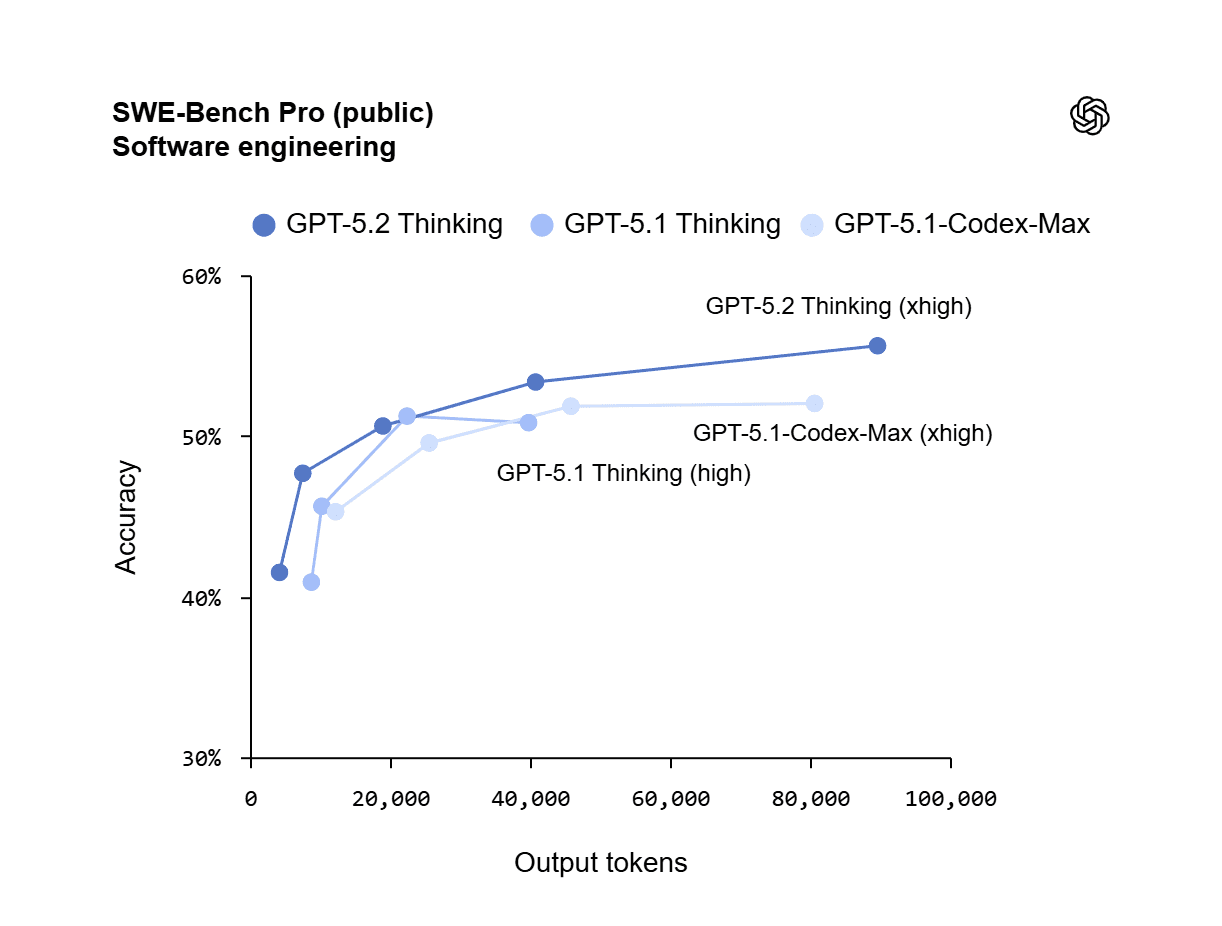
SWE-Bench ProおよびSWE-Bench Verifiedは、GitHubリポジトリ上の実際のソフトウェア課題を解決する能力を評価するベンチマークです。Pythonのみに対応したVerified版とは異なり、SWE-Bench Proは4つのプログラミング言語を対象としており、より高難度かつ産業利用を想定した評価となっています。
出典:OpenAI
GPT-5.2 Thinkingは、SWE-Bench Proにおいて55.6%という新たな最高スコア(SOTA)を記録しました。一方、より実績のあるSWE-Bench Verifiedでは80.0%を達成しています。
この結果は、Claude Opus 4.5(80.9%)とほぼ同水準であり、Gemini 3 Pro(76.2%)を上回る性能です。これは、GPT-5.1(76.3%)からの明確な進化であり、複雑かつマルチ言語にまたがるバグ修正において、プロフェッショナルな開発ワークフローに非常に適したポジションを確立していることを示しています。
推論
推論ベンチマークは、モデルが複雑かつ未知の問題を解決する能力を評価する指標です。GPQA Diamondは博士課程レベルの科学的知識を測定し、ARC-AGI-1およびARC-AGI-2は、暗記では対応できない抽象的な視覚パズルへの対応力に焦点を当てています。これらのベンチマークは、思考しながらマルチステップの指示を遂行できるエージェントを構築するうえで非常に重要です。
GPT-5.2 Thinkingは、GPQA Diamondにおいて92.4%を記録し、GPT-5.1から4.3ポイント向上しました。これは、Gemini 3 Pro(91.9%)をわずかに上回り、高度な科学的質問においてはClaude Opus 4.5(87%)に対して大きな優位性を示しています。中でも、抽象推論能力の向上が最も顕著な進化点です。
出典:OpenAI
特に注目すべきは、ARC-AGI-2での52.9%というスコアです。これは、Claude Opus 4.5(37.6%)を大きく上回り、Gemini 3 Pro(31.1%)のほぼ2倍に近い性能であり、非言語的な問題解決能力が根本的に強化されたことを示しています。
数学
AIME 2025ベンチマークは、難易度の高い数学コンテストをベースにしており、定量的推論能力を評価します。さらに新しいFrontierMathベンチマークは、高度数学の最前線における未解決問題への対応力を測定するものであり、モデルの実力をより端的に示す指標とされています。
GPT-5.2 Thinkingは、ツールを使用せずにAIME 2025で100%の満点を達成し、Claude Opus 4.5と同水準に到達しました。一方で、Gemini 3 Proは他モデルより約5%低い結果となっています。
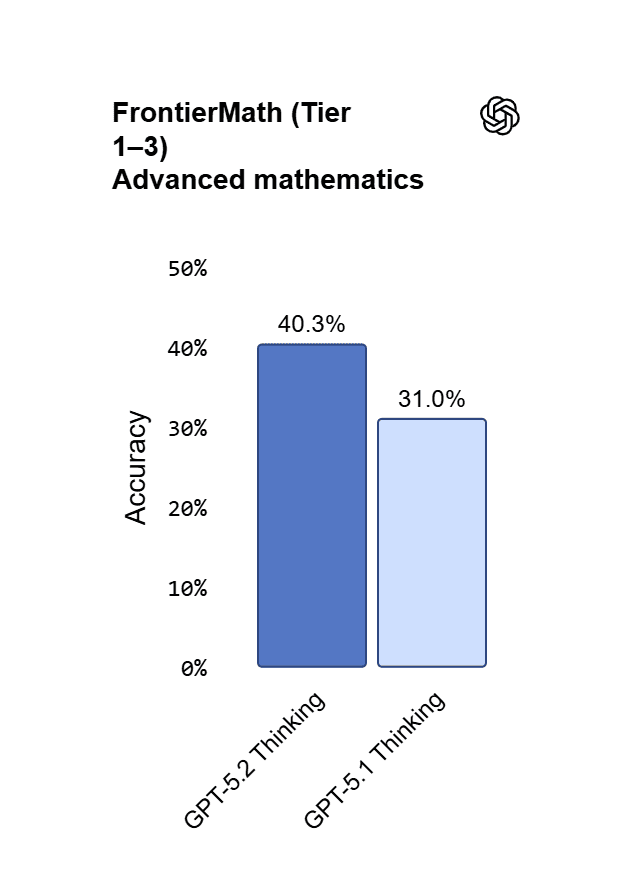
最大の差別化ポイントはFrontierMathでの性能です。GPT-5.2 Thinkingは、Tier 1〜3で40.3%を記録し、GPT-5.1から約10ポイント向上しました。この高いベース性能は、生得的(内在的)な数学的直感がより強化されていることを示しており、解決策を見出すために外部ツールへ過度に依存しないモデルであることを意味しています。
出典:OpenAI
タスク遂行
単発のやり取りを超えて、マルチステップのワークフローを計画し、実行できる能力は、モデルのエージェント的能力(Agentic Capabilities)を測る重要な指標です。GDPvalは、44の専門職にまたがる明確に定義されたナレッジワークタスクを対象に、この能力を評価します。
GPT-5.2は、70.9%の比較において、業界トップレベルの専門家と同等、またはそれ以上の成果を示しました。このベンチマークでは、プレゼンテーションやスプレッドシートといった実際の業務成果物の作成が求められるため、現実的かつ実務に直結した支援能力を測る強力な指標となっています。
この結果は、GPT-5.2が複雑な業務を最初から最後まで一貫して遂行し、長時間にわたって整合性と品質を維持できることを示しています。
長文コンテキスト処理
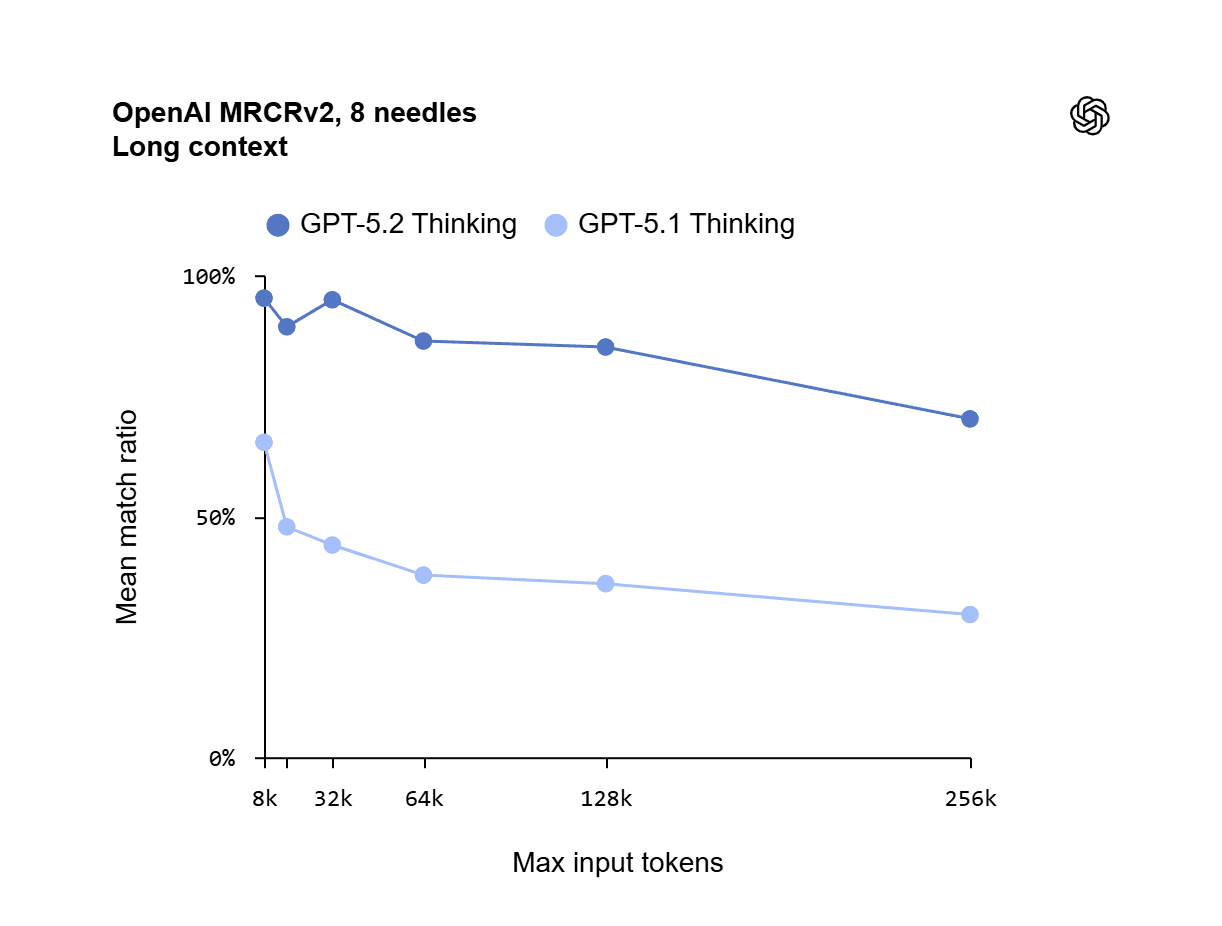
大規模なコンテキストウィンドウの価値は、情報を正確に検索・想起できる能力によって決まります。MRCRv2ベンチマークは、大量のテキストの中から特定の情報を見つけ出す、いわゆる「干し草の山から針を探す(needle-in-a-haystack)」能力を評価します。
出典:OpenAI
GPT-5.2 Thinkingは、ほぼ完璧な想起性能を示し、4-needleテストで98%、8-needleテストで70%というスコアを記録しました。これは、最大256Kトークンのフルコンテキスト内での結果です。
さらに、128Kトークン入力時の8-needleテストでは、平均マッチ率85%を達成しました。これは、Gemini 3 Proの77%を大きく上回る数値です。この結果から、GPT-5.2のコンテキストウィンドウは単に大きいだけでなく、極めて信頼性が高く、膨大な文書の中に埋もれた情報を実務で効果的に活用できることが示されています。
視覚理解
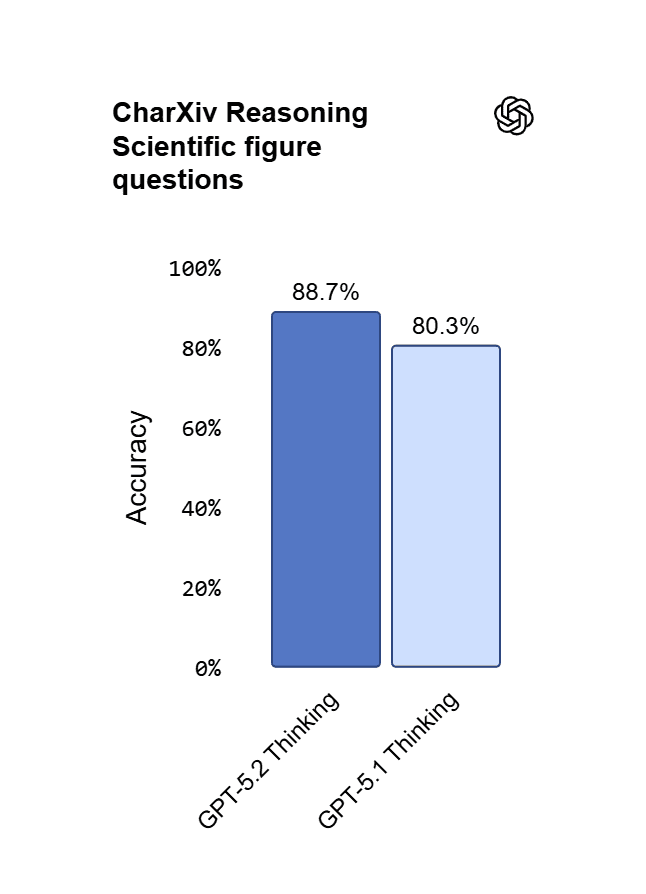
ネイティブなマルチモーダルモデルは、異なるデータ形式を横断して理解・推論する能力によって評価されます。MMMU-Pro、Video-MMMU、CharXivは、画像・動画・科学的図表を統合的に理解できるかを測る主要ベンチマークです。
MMMU-Proにおいて、GPT-5.2は86.5%(Python使用時は90.1%)を記録しました。これは、前世代のGPT-5.1(85.4%)からのわずかな向上であり、Gemini 3 Pro(81%)を引き続き上回る結果です。
Video-MMMUでは、GPT-5.2は90.5%を記録し、Gemini 3 Pro(87.6%)を上回る評価となりました。これは、GPT-5.2の強みが静止画像にとどまらず、動的な動画コンテンツの理解においても高度な能力を持つことを示しています。
さらに、CharXiv(Python使用)ベンチマークでは、GPT-5.2は88.7%という非常に高いスコアを達成し、Gemini 3 Pro(81.4%)を大きく上回りました。この結果は、複雑なデータ可視化や科学的図表を解釈する能力において優位性があることを裏付けています。
出典:OpenAI
ツール呼び出し
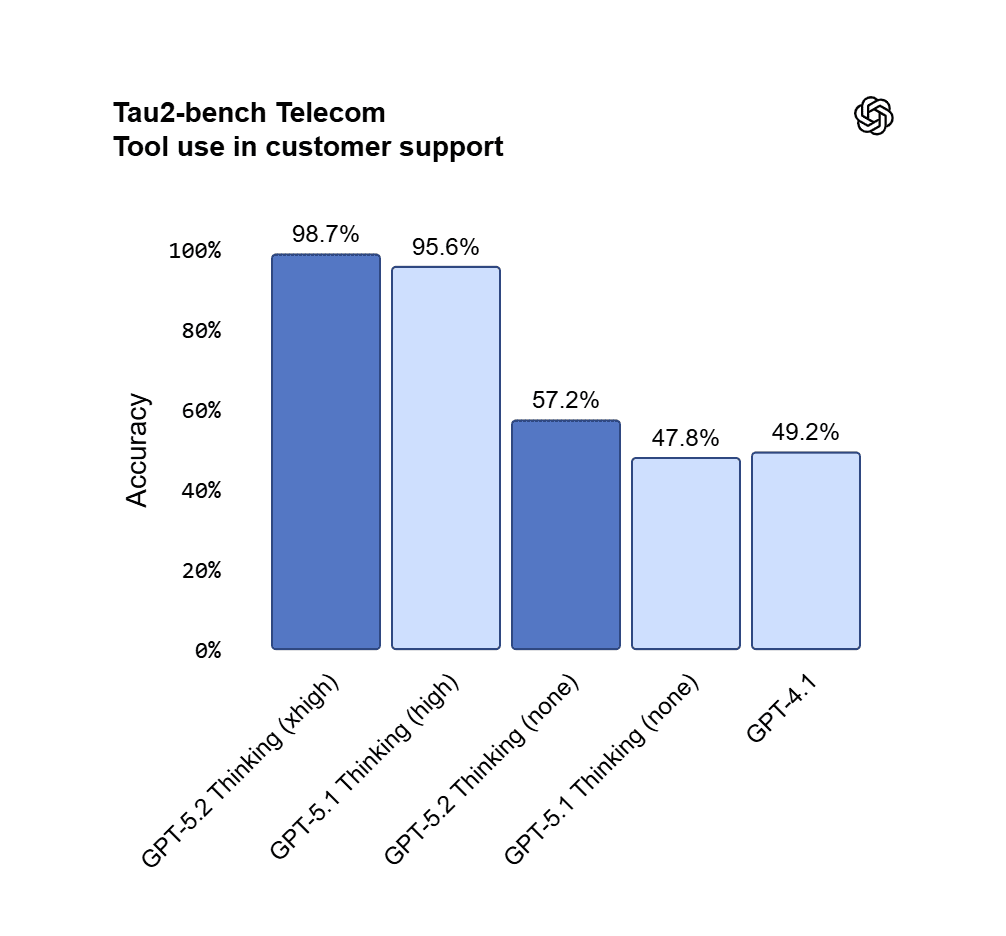
外部ツールを安定して使いこなす能力は、強力なAIエージェントを構築するうえで不可欠です。Tau2-bench Telecomは、通信業界における現実的かつ複雑なツール利用シナリオを通じて、この能力を評価するベンチマークです。
出典:OpenAI
GPT-5.2 Thinkingは、このベンチマークで94.5%を記録しました。これは、Gemini 3 Pro(85.4%)を大きく上回る飛躍的な向上を示しています。一方で、Claude Opus 4.5(98.2%)にはわずかに及ばない結果となっています。
GPT-5.2とGemini 3 Proの比較
モデル概要
GPT-5.2:用途別に最適化された3つのモデル
GPT-5.2は、ChatGPTの有料ユーザー向けおよびAPI経由で、以下の3つのバリエーションが提供されています。
- GPT-5.2 Instant:速度最優先で最適化されたモデルです。日常的な質問対応、情報検索、文章作成、要約、翻訳などに適しています。
- GPT-5.2 Thinking:深い思考を要する業務向けに設計されたモデルです。コーディング、長文ドキュメント分析、数学的推論、計画立案、マルチステップタスクに強みを発揮します。プロフェッショナルなワークフロー向けとしては、OpenAIで最も高度な推論モデルです。
- GPT-5.2 Pro:最高水準の品質と精度を提供する最上位モデルです。難易度の高い質問、複雑なコーディング、科学的推論、ミッションクリティカルな業務を想定しています。
GPT-5.2は、長文コンテキスト処理、構造化推論、ツール活用、事実性、コーディング精度、技術的シナリオにおける視覚理解の面で大幅な進化を遂げています。
なお、ChatGPT単体ではネイティブな動画生成には対応していませんが、利用可能な環境ではSoraと組み合わせて活用することが可能です。
Gemini 3 Pro:Googleの完全マルチモーダルエンジン
Gemini 3 Proは、Googleがこれまでに開発した中で最も高度なモデルであり、テキスト・画像・音声・動画をネイティブに扱う完全マルチモーダルシステムとして設計されています。Google AI Mode、Geminiアプリ、NotebookLM、Androidの各種機能を支え、Gmail、Docs、SearchなどのGoogleサービス全体に統合されています。
LMArenaのような独立系ユーザー評価リーダーボードでは、Gemini 3シリーズは現在、テキスト、ビジョン、テキスト→画像生成、画像編集、マルチモーダル検索の分野で首位を獲得しています。
さらに、Google Veo 3と組み合わせることで、テキスト→動画、画像→動画の分野でもエコシステム全体としてトップクラスの性能を示しています。
Gemini 3 Proは、単なる推論能力にとどまらず、創造性や日常的なインタラクションを重視して設計されたモデルです。
GPT-5.2とGemini 3の比較表
|
カテゴリ |
GPT-5.2 |
Gemini 3 Pro |
|
モデル概要 |
推論重視。3モデル(Instant / Thinking / Pro)で用途別最適化 |
ネイティブ完全マルチモーダル(テキスト・画像・音声・動画) |
|
テキスト推論 |
クラス最高水準の構造化・段階的推論 |
強力だが構造化推論ではやや劣る |
|
コーディング |
SWE-Bench Verifiedで最高クラス。エージェント型開発に強い |
非常に強力だが高度な構造化推論では僅差 |
|
長文コンテキスト |
256Kトークンで高精度な想起・推論 |
良好だが超長文ではトップではない |
|
業務適性 |
スプレッドシート、資料作成、分析、計画立案に最適 |
幅広い用途だが深い業務構造化には最適化されていない |
|
事実性・信頼性 |
精度向上・ハルシネーション低減 |
強力だがマルチモーダル条件で変動あり |
|
SOTA実績 |
ARC-AGI-2、AIME、GPQA Diamond、長文推論 |
画像生成、視覚理解、マルチモーダル検索、動画生成(連携) |
|
画像理解 |
図表・チャート・技術的スクリーンショットに強い |
空間理解・視覚的把握が非常に強力 |
|
画像生成 |
限定的(主軸ではない) |
テキスト→画像、画像編集で業界トップ |
|
音声 |
中程度 |
リアルタイム音声処理が非常に強力 |
|
動画生成 |
ChatGPT単体では非対応(Sora連携時のみ) |
Veo 3連携でテキスト→動画/画像→動画に強み |
|
マルチモーダル性能 |
分析・推論中心のマルチモーダル理解 |
創造性とリアルタイム性に優れる |
|
エコシステム |
ChatGPT、API、エンタープライズ向けツール連携 |
Google Workspace、Android、Search、AI Modeと深く統合 |
|
速度・操作性 |
Instantは高速、Thinking/Proは深い思考向け |
高速かつ流動的なマルチモーダル操作 |
|
想定ユーザー |
開発者、アナリスト、研究者、企業ユーザー |
クリエイター、デザイナー、学生、一般ユーザー |
|
価格傾向 |
入力量が多い業務でコスト効率が高い |
出力量が多い視覚・メディア用途で有利 |
価格プラン
ChatGPT と API におけるモデル名称
| ChatGPT | API |
|---|---|
| ChatGPT-5.2 Instant | gpt-5.2-chat-latest |
| ChatGPT-5.2 Thinking | gpt-5.2 |
| ChatGPT-5.2 Pro | gpt-5.2-pro |
GPT-5.2のAPI価格は以下のとおりです。
-
入力:$1.75 / 100万トークン
-
出力:$14 / 100万トークン
-
キャッシュ済み入力:90%割引($0.175 / 100万トークン)
複数のエージェント型評価において、GPT-5.2はトークン単価自体は高いものの、トークン効率が高いため、同等の品質を達成するための総コストは結果的に低くなることが確認されています。ChatGPTのサブスクリプション料金自体に変更はありません。一方、APIでは、GPT-5.2はGPT-5.1よりも高価格に設定されていますが、これはモデル性能が大幅に向上しているためです。それでも、他の最先端モデルと比較すると依然として競争力のある価格帯に抑えられており、日常業務や基幹アプリケーションでの継続的な利用が想定されています。
トークン単価一覧(100万トークンあたり)
| モデル | 入力 | キャッシュ入力 | 出力 |
|---|---|---|---|
| gpt-5.2 / gpt-5.2-chat-latest | $1.75 | $0.175 | $14 |
| gpt-5.2-pro | $21 | ― | $168 |
| gpt-5.1 / gpt-5.1-chat-latest | $1.25 | $0.125 | $10 |
| gpt-5-pro | $15 | ― | $120 |
よくある質問(FAQ)
GPT-5.2とはなんですか。
GPT-5.2とはOpenAIがこれまでに一般公開された中で最も高度なAIモデルです。単なるチャットボットツールではなく、専門的な業務タスク向けに設計された最先端モデルとして位置づけられています。
GPT-5.2の本質的な強みはどこにありますか?
GPT-5.2の最大の強みは、構造化された推論を長時間維持しながら、実務成果物を作り切れる点にあります。ARC-AGI-2、GPQA Diamond、GDPvalといったベンチマーク結果が示す通り、単発の回答精度ではなく、マルチステップ業務全体の完遂能力が大きく向上しています。
なぜGPT-5.2は「業務向けAI」と評価されているのですか?
GDPvalの結果(70.9%)が示すように、GPT-5.2は44職種にわたる実務タスクを専門家レベルで遂行できます。これは、文章生成だけでなく、スプレッドシート、資料作成、分析、計画立案といった成果物ベースの評価で高い性能を示しているためです。
GPT-5.2 Thinkingが多くのベンチマークで中心的に使われている理由は?
Thinkingは、推論深度・安定性・コスト効率のバランスが最も取れたモデルです。ARC-AGI-2、AIME、FrontierMath、長文コンテキスト評価などで高い一貫性を示しており、エージェント型ワークフローの基盤モデルとして位置づけられています。
Gemini 3 Proと比較した場合の決定的な違いは何ですか?
決定的な違いは 「何を最適化しているか」 です。
-
GPT-5.2:
構造化推論、業務完遂力、長文整合性、ツール連携の安定性 -
Gemini 3 Pro:
完全マルチモーダル、創造性、リアルタイム性、エコシステム統合
性能差というより、設計思想の違いが結果としてベンチマークに表れています。
GPT-5.2の長文コンテキスト性能は実務で何が変わりますか?
MRCRv2の結果が示す通り、GPT-5.2は256Kトークン規模でも高い想起精度を維持します。これにより、仕様書・契約書・研究資料などをまたいだ分析や、長時間にわたる業務コンテキストの維持が現実的になりました。
トークン単価が上がっても「コスト効率が良い」と言える根拠は?
GPT-5.2は、
-
不要な試行錯誤が減る
-
修正回数が少ない
-
一度でタスクを完了できる確率が高い
という点から、品質到達までに必要な総トークン数が減少します。そのため、単価は高くても業務全体の総コストは低下するケースが多いと評価されています。
まとめ
GPT-5.2とは、推論・長文コンテキスト処理・ツール活用・事実性といった、業務利用における本質的な性能を大きく前進させたモデルです。特にGPT-5.2 Thinkingは、コーディング、数学、抽象推論、マルチステップタスクにおいて、複数の主要ベンチマークで最高水準の結果を示しており、エージェント型ワークフローの中核を担う存在となっています。
Instant、Thinking、Proという3モデル構成により、速度重視の軽量業務から、精度と信頼性が求められるミッションクリティカルな用途まで、目的に応じた最適な選択が可能です。トークン単価は上昇しているものの、タスク完了までのトークン効率が高く、総コストの観点では依然として競争力を保っています。
一方、Gemini 3 Proは完全マルチモーダルとGoogleエコシステムとの統合に強みを持ち、創造性や日常的なインタラクション、動画生成を含む用途において優位性を発揮します。対照的にGPT-5.2は、構造化された推論、業務成果物の生成、分析・計画立案といった「仕事を完遂するAI」としての完成度が際立っています。
高度なナレッジワークや業務自動化を本格的に進めたい企業にとって、GPT-5.2は単なるモデルの進化ではなく、AI活用の前提を引き上げる基盤技術となる存在だと言えるでしょう。