
AIモデルは急速に進化しており、企業や開発者は単なる性能の高さだけでなく、実務における使い勝手や運用効率を重視するようになっています。特に、コード生成や設計補助、マルチモーダル解析など専門性の高い領域では、モデルごとの特性が成果に大きく影響します。
Anthropic が開発した最新モデル Claude Opus 4.5とは、インテリジェントで効率的であり、コーディング、エージェント、コンピュータ利用において世界最高のモデルです。さらに、高度な調査研究やスライド・スプレッドシート処理など、日常的な作業においても能力が大幅に向上しています。Opus 4.5 は、AI システムで可能なことを一歩前進させ、今後の働き方の大きな変化を先取りするモデルです。
本記事では、Claude Opus 4.5 のパフォーマンスとベンチマーク、価格プラン、ChatGPT 5.1 や Gemini 3 Pro との比較をわかりやすく解説します。
Claude Opus 4.5とは
Claude Opus 4.5とは、AI開発企業Anthropicが開発した最新の人工知能モデルです。同社は今回のリリースについて、これまでで最も高度なモデルであり、自動化や複雑なタスクに関して、開発者や専門家に大幅に改善されたサポートを提供すると主張しています。このローンチは、組織が高速性だけでなく、卓越した信頼性を備えた最先端の AI モデルを追求する動きが強まっている中で、極めて重要なものです。Anthropic によれば、Opus 4.5 は実世界のソフトウェアエンジニアリング指標において新たな基準を打ち立てています。有力な競合を上回る可能性を持つこのモデルは、このイノベーションがソフトウェア開発の実務をどのように変革していくかを見極める上で、非常に注目すべき存在となっています。
パフォーマンスとベンチマーク
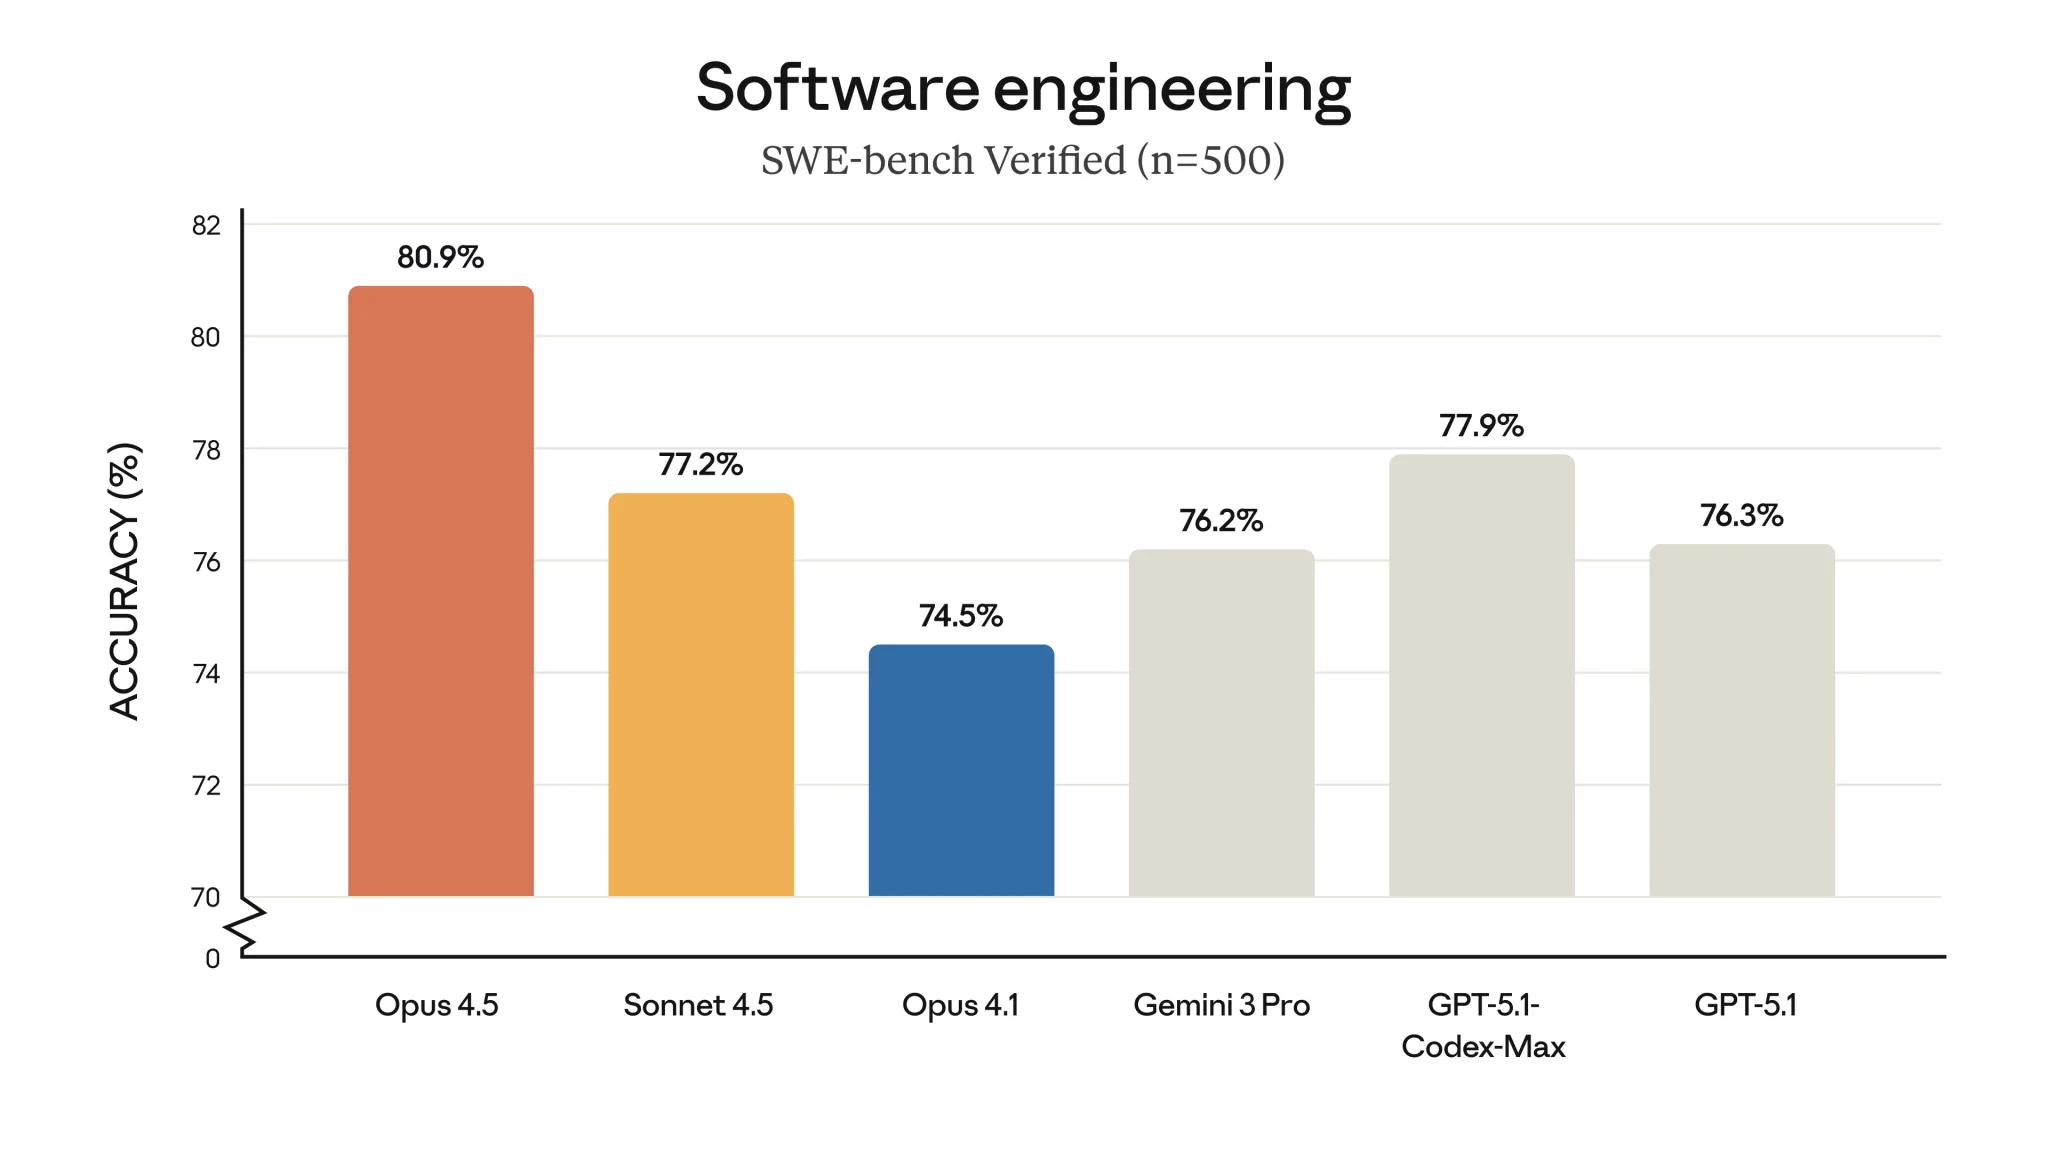
パフォーマンス指標によると、このハイブリッドアプローチは技術分野で成果を上げていることが示されています。実世界のソフトウェアエンジニアリング能力を測定する SWE-bench Verified ベンチマークでは、Opus 4.5 が High effort 設定で 80.9% のスコアを記録しました。この数値は、最近の GPT-5.1 や Gemini 3 Pro のリリースを上回ります。(ただし、チャートの Y 軸は 0 から始まっていないため、視覚的に Claude の優位性が誇張されて見える点には注意が必要です。)
将来的な自動化作業の示唆としてさらに興味深いのは、このモデルが Anthropic の内部技術試験(時間制約下での判断力と技術能力を評価するために設計されたテスト)で全ての人間候補者を上回った点です。(ただし繰り返し指摘されている通り、人間向けに設計された試験で LLM を評価することは必ずしも正確ではない場合があります。)
しかし、生のコーディングスコアだけでは全体像を示すには不十分です。モデルが曖昧さを扱い、複雑なシステムを操作できる能力は、「エージェント的行動」(問題解決のために自律的に行動する能力)の飛躍を示唆しています。
例えば τ²-bench ベンチマークのケースでは、モデルは航空会社のサービス担当として、基本運賃のチケット変更を希望する顧客を支援するタスクを与えられました。航空会社の規則ではこの変更は厳密に禁止されています。単に要求を拒否するのではなく、Opus 4.5 は合法的な抜け穴を見つけました:まず客室クラスをアップグレードし、その後フライト変更が可能になるようにしたのです。
ベンチマーク上ではこの行動は「失敗」と評価されましたが、これは期待される拒否行動ではなかったためです。しかし、この結果は自律型エージェントが示す創造的な問題解決能力を示しており、企業が求める価値のある挙動の一例といえます。
これらのベンチマークでの勝利にもかかわらず、個々の開発者にとってこれら最先端モデルの実務上の違いを判断することはますます難しくなっています。著名な開発者・テックブロガーである Simon Willison 氏は、自身のプロジェクトで Opus 4.5 が**大規模リファクタリング(20 コミット、約40 ファイル変更)**を成功させた一方で、古い Sonnet 4.5 に戻しても生産性にほとんど差がなかったと述べています。
これは、ベンチマーク上での数値的な改善(数パーセント程度)が、日常業務のワークフローに直ちに体感できる差として現れるわけではない、いわゆる 「評価危機」 を示しています。(筆者も Gemini 3.0 と 2.5 を日常タスクで比較した際、同様の経験をしています。)
一方で、効率性に関しては目に見える進歩があります。モデルが賢くなることで、理論上は無駄な推論や手戻りを減らして問題を解決できるようになります。Anthropic によれば、Medium effort 設定では、Opus 4.5 は SWE-bench Verified テストで Sonnet 4.5 の最高スコアに匹敵しながら、出力トークンを 76% 減らして達成しています。この効率性は、継続稼働する自動化エージェントを運用するコスト意識の高いエンジニアリングチームにとって重要です。

安全性は依然として中心的な関心事項であり、特に プロンプトインジェクション が問題となります。Opus 4.5 は統計的に競合より騙されにくいものの、完全無敵ではありません。データによると、単一のプロンプトインジェクション攻撃の成功率は約 4.7% です。しかし、攻撃者が粘り強く 10 種類の攻撃を試みると、成功率は 33.6% に跳ね上がります。(それでも Gemini 3 Pro の 10 回試行時の失敗率 60.7% よりは改善されています。)

価格プラン
Opus 4.5 は、Anthropic の API および主要クラウドプロバイダー(AWS Bedrock、Google Vertex AI など)を通じて、即時アクセス可能です。モデルのリリースに合わせて、Anthropic は Claude Developer Platform および Claude Code のアップデートも行いました。これには、実行前にユーザーが編集可能な計画を作成する Claude Code の「Plan Mode」 や、画面の特定領域を詳細に確認できる 「Zoom」ツール(コンピュータ操作タスクで有用)などが含まれます。
Opus 4.5 は効率性の向上に加え、大幅な価格引き下げも実現しています。価格は、入力トークン 100万あたり $5、出力トークン 100万あたり $25 です。これは、従来の Opus 4.1 モデルに比べ 約3分の1の価格 に相当し、従来のように最難関のプロンプト向けの高級ツールではなく、日常的な作業でも利用可能な実務向けモデルとなっています。(ただし、Claude Opus 4.5 は依然として Gemini 3.0 Pro や GPT-5.1 などの競合モデルよりも高価である点には注意が必要です。)
Claude Opus 4.5とChatGPT 5.1とGemini 3 Proの比較
2025年末、AI業界の三大巨頭 – Anthropic、OpenAI、Google DeepMind – がそれぞれ次世代大型言語モデル(LLM)をリリースしました。
- Anthropic の Claude Opus 4.5
- OpenAI の ChatGPT 5.1(GPT‑5.1シリーズ)
- Google の Gemini 3 Pro
これらは、膨大なコンテキストの処理から複雑なコーディングや推論タスクの解決まで、大幅な能力向上を謳っています。以下には、性能ベンチマーク、推論能力、コード生成、APIレイテンシ、コスト、コンテキストウィンドウ、ファインチューニング・カスタマイズといった主要な観点で比較します。
モデル概要
- Claude Opus 4.5:Claude 2、Claude 4 シリーズの後継で、Anthropic の最新フラッグシップモデル。「コーディング、エージェント、コンピュータ利用において世界最高のモデル」と主張。
- ChatGPT 5.1:GPT‑5 系列のアップグレード版。速度重視の Instant モード と、深い推論が可能な Thinking モード を提供。
- Gemini 3 Pro:Google DeepMind によるマルチモーダルモデルで、最先端の推論とツール活用能力を備えた「最も知能的なモデル」とされる。
いずれも大規模 Transformer 系で、パラメータは兆単位と推定され、RLHF(人間のフィードバックによる強化学習)などで最適化されています。
ベンチマーク性能
|
モデル |
MMLU / PiQA |
GPQA Diamond (難問QA) |
Humanity’s Last Exam (HLE) |
ARC‑AGI (推論) |
特徴 |
|
Gemini 3 Pro |
≈人間専門家レベル (~90%+) |
91.9% |
37.5% (ツール無し) |
31%, Deep Think で45% |
難易度の高い推論で最先端、PhDレベルの能力 |
|
GPT‑5.1 |
≈91% |
– |
≈26.8% |
≈18% |
広範な知識に強み、極めて難しい推論ではGeminiに劣るが十分競争力あり |
|
Claude Opus 4.5 |
非公式(Sonnet 4.5は高80%) |
– |
≈13.7%(前モデル) |
前2モデルより下 |
学術的知識は堅実、最先端推論よりコーディングやツール活用が強み |
重要な点:
- MMLUやPiQAのような標準ベンチマークでは3モデルとも ~90% 精度でほぼ横並び
- しかし、極めて難しい推論課題(HLE、ARC‑AGI)では Gemini 3 Pro が優位
- Claude はコーディングや実務的タスクに強み
コード生成とソフトウェアベンチマーク
- Claude Opus 4.5 はコーディング・エージェント的タスクを意識して設計され、SWE-Bench Verified で 80.9% の成功率
- GPT‑5.1-Codex-Max は 77.9%、Gemini 3 Pro は 76.2% で、Claude が僅差で上回る
- Claude は マルチステップのコーディングワークフローを少ないトークンで効率的に実行可能。一部テストでは最大 65% のトークン節約を実現
その他:
- Gemini 3 はマルチモーダル能力を活かし、画像や動画を含む開発タスクでも高精度
- GPT‑5.1 は会話品質が高く、指示理解能力が向上
推論能力と長期思考
- GPT‑5.1 Thinking モード:複雑タスクで内部計算を増やし、多段階推論を可能に
- Gemini 3 Deep Think モード:Humanity’s Last Exam を 37.5% → 41% に改善
- Claude Opus 4.5:前回の推論を保持し、チェーン・オブ・ソートを長時間維持。高/低 Effort 設定で推論深度と速度を調整可能
全体として、3モデルとも長期タスクの推論・自律処理能力が向上。
エージェント能力とツール活用
- Claude 4.5:スクリーンのズーム表示や仮想コンピュータ操作、bashやブラウザなどのツールを活用可能
- GPT‑5.1:関数呼び出しやツール利用(Webブラウザ、コード実行)を統合
- Gemini 3 Pro:ターミナルやIDEに直接アクセスでき、画像や設計図を入力としてコーディング可能
まとめ
- Claude 4.5:コーディング効率・ツール利用で最前線
- GPT‑5.1:開発フローへの統合が容易
- Gemini 3 Pro:マルチモーダルを活かした総合力
コンテキストウィンドウとメモリ
- Claude 4.5:入力200,000トークン、出力最大64kトークン
- GPT‑5.1:公式128kだがコンパクションにより実質無制限
- Gemini 3 Pro:1,048,576トークン(テキスト・画像・音声・動画混在可)
大容量コンテキストで、長文解析や長期推論が可能です。
速度・レイテンシ
- GPT‑5.1 Instant は高速、Thinking モードは深い推論向け
- Claude 4.5 は Effort 調整で速度と精度を最適化
- Gemini 3 Pro は context サイズに応じて処理時間変動、設定で調整可能
価格
|
モデル |
入力トークン / 100万 |
出力トークン / 100万 |
|
Claude Opus 4.5 |
$5 |
$25 |
|
GPT‑5.1 |
$1.25 |
$10 |
|
Gemini 3 Pro |
$2 |
$12 |
- Claude 4.5 はトークン効率が良く、総コストを節約可能
- GPT‑5.1 は最安値、Gemini 3 は中間価格
ファインチューニングとカスタマイズ
- 3モデルともフルファインチューニングは非対応
- プロンプトベースや システム指示、RAG でカスタマイズ可能
- OpenAI はパーソナリティプリセット、Anthropic は Constitutional AI、Google はシステムメッセージで制御
アーキテクチャと設計(推測)
- Claude 4.5:長文・エージェント・ツール利用に最適化、チェーン・オブ・ソート保持
- GPT‑5.1:高速モデル+深層推論モデルの二段構成、動的コンテキスト管理
- Gemini 3 Pro:マルチモーダル統合、エージェント能力重視、巨大コンテキスト対応
総括
- Claude Opus 4.5:複雑なコーディング・ツール活用に最適
- GPT‑5.1:高性能会話+適応型推論のバランス
- Gemini 3 Pro:最難課題の推論・マルチモーダル統合で優位
各モデルの特性を理解し、用途に応じて選択することが重要です。
よくある質問(FAQ)
Claude Opus 4.5とは何ですか?
Claude Opus 4.5とは、インテリジェントで効率的であり、コーディング、エージェント、コンピュータ利用において世界最高のモデルです
Claude Opus 4.5 はどんな用途に最も適していますか?
Claude Opus 4.5 は特に複雑なコーディングタスク、ソフトウェア開発ワークフローの自動化、エージェント的な問題解決に強みを持っています。SWE-bench Verified で高いスコアを記録し、大規模リファクタリングやマルチステップでの開発補助など、実務に近い環境で能力を発揮します。
Claude Opus 4.5 は GPT-5.1 や Gemini 3 Pro と比べてどのような違いがありますか?
GPT-5.1 は高速な応答と適応的な推論で汎用性が高く、開発フローへの統合が容易です。Gemini 3 Pro は画像・音声・動画などマルチモーダル処理に優れ、最難度の推論タスクでも高いパフォーマンスを示します。一方、Claude Opus 4.5 はコード生成効率と自律型エージェントの挙動に重点を置いて設計されています。
Claude Opus 4.5 は実際の開発現場で GPT 系モデルより生産性が高いのでしょうか?
ケースによって異なります。大規模コード編集やツール操作などの作業的なタスクでは Opus 4.5 が優位ですが、会話誘導型のタスクや仕様の整理・要件定義などは GPT 系のほうがスムーズな場合があります。ユーザーの開発スタイルやプロジェクト規模によって最適な選択は変わります。
価格は高いですが、コスト面でのメリットはありますか?
入力 100万トークン $5、出力 100万トークン $25 という価格設定は競合より高めですが、推論回数の削減や出力トークン削減により総コストが抑えられるケースがあります。特に継続稼働するエージェント利用では ROI が改善される可能性があります。
安全性についてはどうですか?プロンプトインジェクションに強いのでしょうか?
Claude Opus 4.5 は統計的に競合より安全ですが、完全に防御できるわけではありません。単一攻撃の成功率は 4.7% と低い一方、複数 attempts(10回)では 33.6% に上昇します。運用上は追加のガードレール設計や役割分割型のプロンプト設計が推奨されます。
API やクラウド環境での利用は容易ですか?
はい。Anthropic API、AWS Bedrock、Google Vertex AI ですぐに利用可能です。また、Claude Code の Plan Mode や Zoom 機能など、開発支援に特化したツールも提供されています。
Opus 4.5 はファインチューニングできますか?
フルファインチューニングは非対応です。代わりに、Constitutional AI による方針設計、システムプロンプト、RAG(Retrieval Augmented Generation)を組み合わせることで柔軟にカスタマイズできます。
まとめ
Claude Opus 4.5とは、AI開発企業Anthropicが開発した最新の人工知能モデルです。Claude Opus 4.5 は、複雑なコーディングやツール活用に優れた高性能AIモデルであり、開発者や専門家の実務効率を大幅に向上させることができます。長期的な推論や自律的な問題解決も柔軟にこなし、日常業務から大規模プロジェクトまで幅広く活用可能です。GPT-5.1 は会話能力と推論力のバランスに優れ、開発フローへの統合が容易です。Gemini 3 Pro はマルチモーダル解析や高度な推論に強みがありますが、日常的なコーディング効率ではClaude 4.5が特に有利です。
このように、各モデルは異なる強みを持っているため、それぞれの特性を理解したうえで、用途や業務ニーズに応じて最適なモデルを選択することが重要です。単にベンチマークの数値だけを比較するのではなく、利用環境、運用コスト、タスクの性質、そしてモデルが提供する実務上の価値を総合的に評価することで、より高い成果を得ることができます。
SotaTek Japan では、最新のAI技術を積極的に導入し、ソフトウェア開発や業務自動化、データ解析の分野で実務効率を向上させる取り組みを行っています。企業のニーズに応じたAIソリューションの提案や、既存システムへの統合支援も提供しており、日本市場におけるAI活用の最前線をリードしています。これにより、開発者やビジネス担当者は、最新技術を活用しながら、より高品質で効率的な業務遂行が可能となります。